Last Updated on 11월 21, 2026 by Jade(정현호)
안녕하세요
이번글은 PostgreSQL 고가용성 구성 3번째 글로 이전글에서 이어지는 글입니다.
PostgreSQL 메이저 버전 업그레이드 개요
이번 글에서는 Patroni와 etcd로 구성한 PostgreSQL 17버전 3노드 HA 클러스터를 PostgreSQL 18버전으로 업그레이드하는 절차를 정리합니다. 클러스터 구성은 이전글의 PostgreSQL 17버전 Patroni etcd 3노드 HA 구성 글의 구성을 그대로 사용합니다.
PostgreSQL은 메이저 버전이 다른 서버 간에 Physical Streaming Replication을 구성할 수 없습니다. 따라서 기존 Leader를 먼저 업그레이드하고 Replica를 순차적으로 업그레이드하는 롤링 방식은 사용할 수 없습니다.
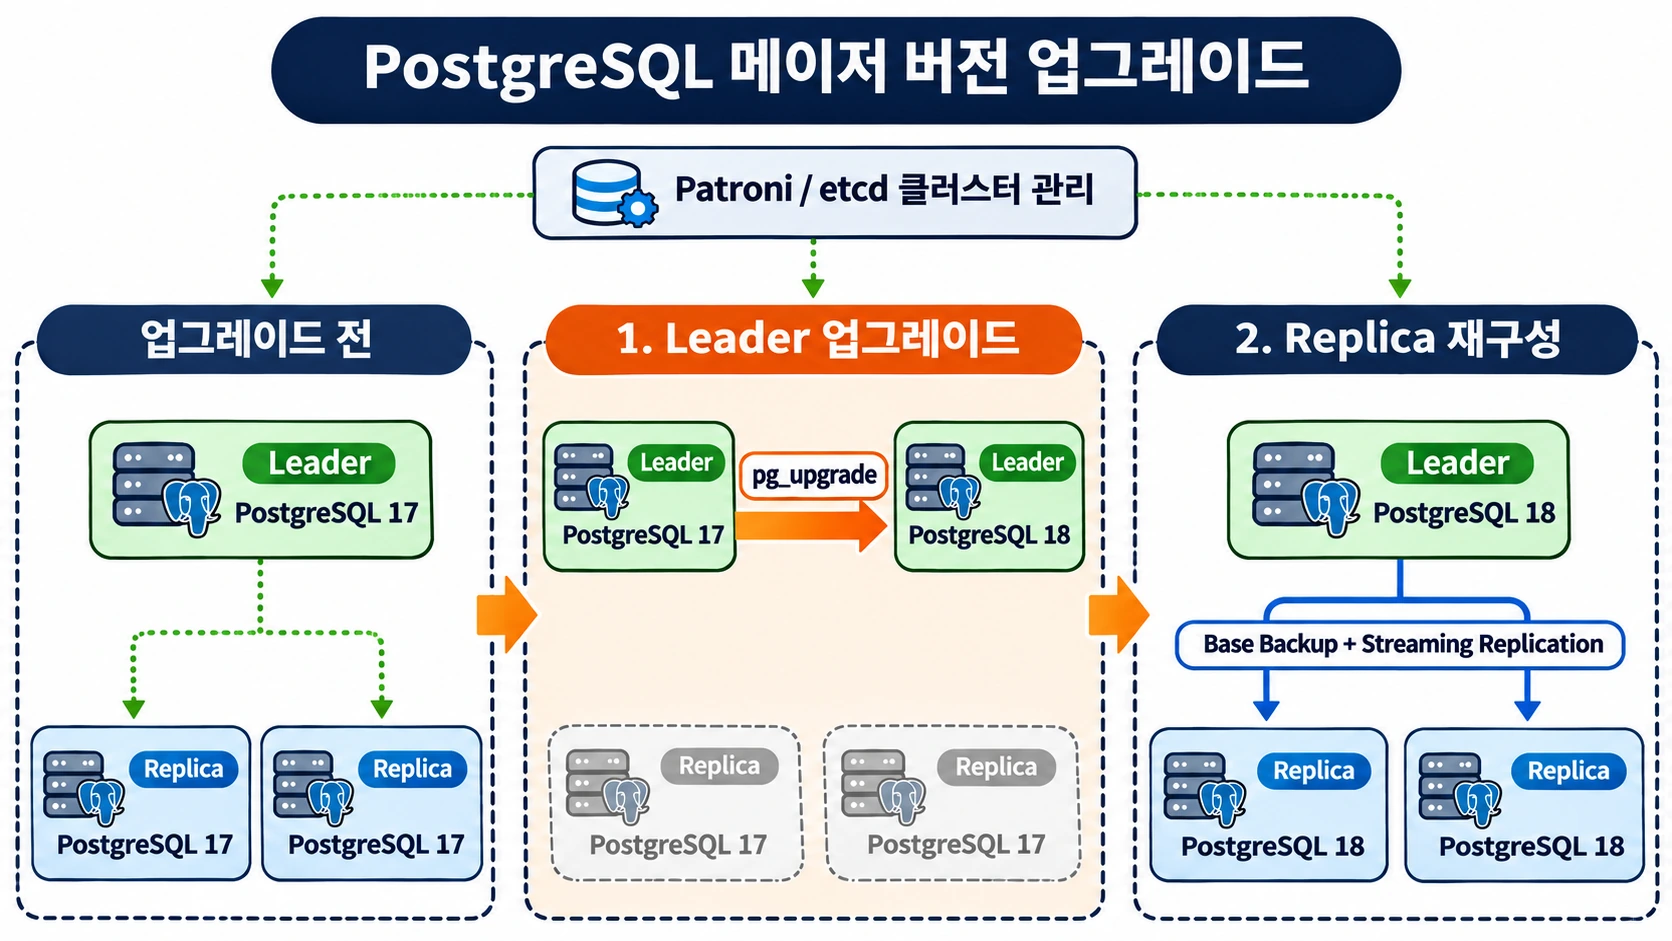
따라서 이 글에서 구성한 Patroni 클러스터 역시 Leader 한 대에서 pg_upgrade(구 버전 클러스터의 데이터를 새 버전 클러스터로 옮기는 PostgreSQL 도구)를 수행한 뒤, 나머지 Replica 노드는 새 Leader의 데이터를 다시 복제받도록 구성합니다. 이 과정에서는 클러스터 전체의 서비스 중단이 필요합니다.
위에서 Replica 노드에서는 Leader의 데이터를 복사하여 복제를 다시 받도록 구성한다고 하였습니다. 그래서 이 글에서는 한 가지 가정을 추가합니다. 3번 노드(pg_server3)가 다른 PostgreSQL 17버전(DR DB)에 Logical Replication(테이블의 행 변경을 다른 PostgreSQL로 전달하는 복제 방식)으로 데이터를 제공하고 있다는 환경이라고 가정합니다. 그래서 3번 노드는 업그레이드 직전에 Logical Slot 을 생성하고 진행하였으며, 업그레이드 이후 3번 노드에서 Logical Slot의 상태를 확인합니다.
업그레이드 대상 환경
업그레이드 진행하기전에 업그레이드를 진행하는 시스템 대상 환경에 대해서 간략하게 설명하도록 하겠습니다.
구성 요소
글의 구성에서 사용되는 요소는 다음과 같습니다.
- PostgreSQL: PostgreSQL는 17버전에서 18버전으로 메이전 버전 업그레이드 수행합니다.
- Patroni: PostgreSQL 인스턴스의 시작과 중지, Leader 선출, Replica 구성, failover를 관리하는 HA 관리 도구입니다. 이 구성에서 PostgreSQL은 Patroni가 시작합니다.
- etcd: Patroni가 클러스터 상태와 설정을 저장하는 분산 키-값 저장소입니다. Patroni에서는 이 저장소를 DCS(Distributed Configuration Store)라고 부릅니다.
- PgBouncer: 애플리케이션과 PostgreSQL 사이에서 연결을 관리하는 커넥션 풀러입니다. 이 구성에서 애플리케이션은 PgBouncer를 거쳐 접속합니다.
- HAProxy: Patroni REST API의 응답(/primary, /replica)을 확인해 Leader 또는 Replica로 요청을 전달하는 로드 밸런서입니다.
- keepalived: VIP(Virtual IP)를 관리합니다. VIP는 한 서버에 할당되어 있다가 해당 서버에 문제가 생기면 다른 서버로 이동합니다.
- Leader와 Replica: Patroni에서 쓰기를 처리하는 노드를 Leader, Leader의 변경을 복제받는 노드를 Replica라고 합니다.
서버 구성
| 서버 또는 VIP | IP 주소 | 역할 |
| pg_server1 | 192.168.56.3 | PostgreSQL + Patroni + etcd (이 글에서는 현재 Leader) |
| pg_server2 | 192.168.56.4 | PostgreSQL + Patroni + etcd (Replica) |
| pg_server3 | 192.168.56.5 | PostgreSQL + Patroni + etcd (Replica, DR DB publisher) |
| pgbouncer_server1 | 192.168.56.6 | PgBouncer + HAProxy + keepalived |
| pgbouncer_server2 | 192.168.56.7 | PgBouncer + HAProxy + keepalived |
| VIP1, VIP2 | 192.168.56.8, 192.168.56.9 | 각 PgBouncer가 listen하는 VIP |
업그레이드 대상과 경로
업그레이드에 사용하는 현재 시스템 디렉토리 현황 정보 및 업그레이드 하면서 변경되는 디렉토리 정보입니다.
| 항목 | 업그레이드 전 | 업그레이드 후 |
| PostgreSQL | 17 | 18 |
| 바이너리 경로 | /usr/pgsql-17/bin | /usr/pgsql-18/bin |
| 데이터 경로 | /data/pgdata/17 | /data/pgdata/18 |
| 로그 경로 | /data/pglog | /data/pglog |
| Patroni 설정 | /etc/patroni/patroni.yml | 동일한 설정파일에서 data_dir, bin_dir 경로만 변경 |
| etcd, PgBouncer, HAProxy, keepalived | 변경 없음 | 변경 없음 |
Replica 노드에서의 Logical Replication 구성
글에서는 3번 노드에서 DR 용 DB 연결을 위해서 Logical Replication을 구성하였다고 가정합니다. 여기서 내용을 조금더 이해하려면 PostgreSQL의 Physical Replication 과 Logical Replication 두 가지 복제 방식을 구분해서 확인해야합니다.
- Physical Replication(Streaming Replication): Primary의 WAL을 Replica가 그대로 받아 적용합니다. Replica는 Primary와 같은 데이터 파일 구조를 가지므로 메이저 버전이 같아야 합니다.
- Logical Replication: WAL의 변경 내용을 테이블 단위의 행 변경으로 해석해서 다른 PostgreSQL에 전달합니다. 보내는 쪽을 publisher, 받는 쪽을 subscriber라고 하며, 데이터만 전달하고 구조(DDL)는 보내지 않습니다. Physical Replication과 달리 원본과 대상의 메이저 버전이 달라도 복제할 수 있으며 CDC(Change Data Capture, 변경 데이터 캡처)에서도 Logical Replication을 사용합니다.
Logical Replication에서는 logical slot이 중요합니다. logical slot은 publisher에 만들어지며, subscriber에게 아직 전달하지 못한 변경을 보관하고 어디까지 전달했는지 위치를 기록합니다. 이 글의 업그레이드에서 가장 주의할 부분이 이 slot입니다. 업그레이드 과정에서 3번 노드의 데이터 디렉터리를 새 Leader에서 다시 복제받아 만들기 때문에 slot을 잃어버릴 수 있기 때문입니다.
pg_server1 (Leader)  ──Physical──▶  pg_server2 (Replica)
        │
        └──────────Physical──▶  pg_server3 (Replica, nofailover)
                                      │
                                      │ Logical Replication (logical slot은 pg_server3에 존재)
                                      ▼
                                  DR DB (PostgreSQL 17, subscriber)
업그레이드 방식 선택
이 절에서는 메이저 버전 업그레이드시 선택 가능한 방법 및 차이점 등을 확인해보도록 하겠습니다.
메이저 버전 업그레이드 방식
PostgreSQL 메이저 버전 업그레이드에는 주로 다음 세 가지 방식을 사용합니다.
| 방식 | 서비스 중단 | 복잡도 | 비고 |
| pg_upgrade를 통한 업그레이드 | 업그레이드 시간만큼 발생 | 낮음 | 파일 처리 방식(--copy, --clone, --link, --swap)에 따라 업그레이드 시간과 롤백 가능 범위가 달라집니다. |
| Logical Replication 기반 전환 | 전환 순간의 짧은 중단 | 높음 | 18 버전 클러스터를 따로 구축하고 복제 설정, DDL, 시퀀스, 전환 검증을 직접 처리해야 합니다. |
| 새 클러스터 구성 후 덤프/복원 마이그레이션(pg_dumpall) | 데이터 크기에 비례 | 중간 | extension 설치와 설정 파일 적용을 직접 챙겨야 하고, 데이터를 SQL로 모두 내려받아 새로운 18 버전 클러스터에 다시 넣으므로 대용량에서는 중단이 길어집니다. |
위와 같은 방법이 메이저버전을 업그레이드 하는데 사용할 수 있는 대표적인 방법 3가지 이며, 글에서는 pg_upgrade를 통해서 업그레이드를 진행하였습니다.
pg_upgrade 파일 처리 방식
pg_upgrade는 구 버전 클러스터의 데이터를 새 버전 클러스터로 옮기는 도구입니다. 데이터 파일을 옮기는 방법으로 --copy, --clone, --link, --swap 옵션을 제공하며, 기본 동작은 --copy 입니다.
pg_upgrade를 실행하려면 새 버전(18) 클러스터를 initdb로 먼저 초기화해 두어야 하며, 새 클러스터를 시작할 필요는 없습니다. 이때 initdb 옵션(인코딩, 로케일, checksum 등)은 구 클러스터(17)와 같아야 합니다.
pg_upgrade는 구 클러스터와 새 클러스터의 데이터 디렉터리와 실행 파일(bin) 디렉터리를 각각 지정해서 실행하므로, 어느 방식을 쓰더라도 구 클러스터(17)와 새 클러스터(18)는 서로 다른 데이터 디렉터리를 사용합니다. 방식은 새 클러스터의 데이터 디렉터리에 구 클러스터의 데이터 파일을 어떻게 가져오는지만 정합니다.
방식을 구분하는 기준은 두 가지입니다. 데이터 파일을 복사하는지 같은 파일을 공유하는지, 그리고 새 클러스터를 시작한 뒤에도 구 클러스터를 다시 시작할 수 있는지입니다.
--copy
- 구 클러스터의 데이터 파일을 새 클러스터의 데이터 디렉터리로 복사합니다. 새 클러스터는 복사된 별도의 파일을 사용하므로, 새 클러스터가 데이터를 변경해도 구 클러스터의 파일에는 영향이 없습니다. 업그레이드 후 문제가 생기면 구 클러스터를 그대로 다시 시작할 수 있습니다.
- 파일을 모두 복사하므로 데이터 크기에 비례해 시간이 걸리고, 새 클러스터의 데이터 파일을 저장할 디스크 공간이 추가로 필요합니다.
- 구 클러스터와 새 클러스터의 데이터 디렉터리가 같은 파일 시스템에 있어야 한다는 조건이 없습니다.
--link
- 파일을 복사하지 않고 하드 링크를 만듭니다. 하드 링크는 하나의 파일에 이름이 두 개 붙는 것으로, 구 클러스터와 새 클러스터가 같은 파일을 함께 사용합니다. 파일을 복사하지 않고 기존 파일을 그대로 사용한다는 점에서 In-Place 업그레이드에 가까운 방식입니다.
- 복사가 없어 훨씬 빠르고 디스크 공간도 덜 사용합니다. 대신 하나의 파일을 두 클러스터가 공유하므로, 새 클러스터(18)를 시작해서 데이터를 쓰면 구 클러스터(17)가 보는 같은 파일도 함께 바뀝니다. 그래서 새 클러스터를 시작하면 구 클러스터를 사용할 수 없습니다. 이 경우 구 클러스터는 백업에서 복원해야 합니다.
- 새 클러스터를 시작하기 전이라면 구 클러스터로 되돌릴 수 있습니다. 링크가 시작될 때 구 클러스터의 $PGDATA/global/pg_control에 .old 접미사가 붙으므로, 이 접미사를 제거하면 구 클러스터를 다시 시작할 수 있습니다.
- 구 클러스터와 새 클러스터의 데이터 디렉터리가 같은 파일 시스템에 있어야 합니다. 테이블스페이스와 pg_wal은 다른 파일 시스템에 있어도 됩니다.
--clone
- 새 클러스터의 데이터 디렉터리에 구 클러스터 파일의 reflink(파일 클로닝) 복제본을 만들어, 데이터 파일을 거의 즉시 복사합니다. --link의 속도 이점을 가지면서 구 클러스터를 건드리지 않습니다.
- --link와 달리 파일이 둘입니다. 구 클러스터와 새 클러스터가 각자의 파일을 가지지만, 처음에는 데이터를 복사하지 않고 같은 디스크 블록을 가리킵니다. 새 클러스터가 데이터를 바꾸면 바뀌는 블록만 새 블록에 따로 쓰고(Copy-on-Write), 구 클러스터의 파일은 바뀌지 않습니다. 그래서 새 클러스터를 시작해도 구 클러스터를 사용할 수 없게 되지 않습니다.
- 처음에는 추가 디스크 공간이 거의 필요 없고, 새 클러스터가 데이터를 바꾸는 만큼 사용량이 늘어납니다.
- --clone을 사용해도 새 클러스터(18)는 별도의 data_dir을 가지며, 17버전의 data_dir은 그대로 남아 있습니다. 롤백은 --copy와 같은 방식으로 합니다. --link나 --swap을 사용하지 않았다면 구 클러스터는 수정되지 않은 상태이므로, 문제가 생기면 구 클러스터를 다시 시작하면 됩니다. --clone으로 만든 새 클러스터가 바꾼 블록은 새 클러스터의 파일에만 기록되어 구 클러스터의 파일에는 영향을 주지 않습니다.
- 구 클러스터와 새 클러스터의 데이터 디렉터리가 같은 파일 시스템에 있어야 합니다.
- 지원하는 환경은 Linux 커널 4.5 이상의 Btrfs와 XFS(reflink 지원으로 생성된 파일 시스템), macOS의 APFS입니다. 지원하지 않는 환경에서 선택하면 pg_upgrade가 오류로 종료됩니다.
--swap
- 구 클러스터의 데이터 디렉터리를 새 클러스터로 이동한 뒤, 카탈로그 파일을 새 클러스터용으로 교체합니다. 릴레이션이 많은 클러스터에서 특히 빠를 수 있습니다.
- 파일 이전 단계가 시작되면 구 클러스터가 파괴적으로 수정되어 더 이상 안전하게 시작할 수 없습니다. 새 클러스터를 시작하기 전에 이미 되돌릴 수 없는 시점이 올 수 있다는 점이 --link와 다릅니다.
- 구 클러스터와 새 클러스터의 데이터 디렉터리가 같은 파일 시스템에 있어야 합니다.
방식별로 표로 비교하면 다음과 같습니다.
| 구분 | --copy(기본값) | --clone | --link | --swap |
| 파일 처리 | 복사 | 블록 공유(Copy-on-Write) | 같은 파일 공유 | 디렉터리 이동 |
| 구 클러스터 롤백 | 가능 | 가능 | 새 클러스터 시작 후 불가 | 파일 이전 시작 후 불가 |
| 같은 파일 시스템 | 불필요 | 필요 | 필요 | 필요 |
| 추가 조건 | 없음 | reflink 지원 환경 | 없음 | PostgreSQL 18 이상 |
글에서는 --copy 방식으로 업그레이드를 선택하여 진행하였습니다. --copy는 17버전의 데이터 파일을 수정하지 않고 18버전의 data_dir로 복사하기 때문에, 18버전을 시작해 데이터가 바뀌어도 17버전의 파일은 그대로 남습니다. 그래서 문제가 생기면 bin_dir과 data_dir을 17버전으로 되돌려 구 클러스터를 다시 시작할 수 있습니다.
롤백을 고려하여 상황별 선택 기준을 표로 정리해보면 다음과 같습니다.
| 상황 | 선택 |
| 롤백을 단순하게 유지하고 싶고 복사 시간이 문제되지 않는 경우 | --copy |
| 데이터가 커서 복사 시간이 문제이고 롤백도 필요한 경우 | --clone (파일 시스템이 reflink를 지원해야 합니다) |
| 시간이 최우선이고 롤백을 백업에 맡길 수 있는 경우 | --link 또는 --swap (작업 전에 복구 가능한 백업이나 스냅샷이 반드시 필요합니다) |
업그레이드 전체 흐름
이 글에서는 사용한 pg_upgrade의 copy 방식으로 진행할 경우 다음과 같은 흐름으로 진행되게 됩니다. 환경이나 상황마다 조금씩 달라질 수 있으며 아래 흐름에서 Read Replica 인스턴스에서만 적용된 내용이나 차이점이 있을 경우도 고려하여 설정 파일 적용 과정이 포함되어있습니다.
| 단계 | 시점 | 내용 |
| 1 | 점검 시작전 | 사전 점검, PG18 패키지 설치, 새 데이터 디렉터리 준비, 현재 상태 기록, 백업, pg_upgrade --check, patroni.yml.pg18 준비, 공지와 메인터넌스 윈도우 확정 |
| 2 | 점검 시작(서비스 중지) | 애플리케이션 쓰기 차단, 변경 사항 반영 확인, DR DB 구독 비활성화 |
| 3 | Patroni 중지 | pg_server3, pg_server2, pg_server1 순서로 중지 |
| 4 | pg_upgrade | pg_server1에서만 수행 |
| 5 | Patroni 재구성 및 Leader 시작 | 설정 파일 적용, patroni.yml 변경, DCS 정리와 patroni.dynamic.json 복사, pg_server1 시작, DCS 설정(wal_level)과 확장 업데이트(update_extensions.sql, 생성된 경우) 확인 |
| 6 | Replica 재구축 | pg_server2, pg_server3 순서로 Replica 재복제, Replica 설정 파일 적용(Patroni 중지, 17 설정 파일 복사, 재시작) |
| 7 | 3번 노드 후처리 | logical slot 재생성, DR DB 구독 재개 |
| 8 | 서비스 재개 | 통계 갱신, 검증, PgBouncer 재개 |
| 9 | 안정화 기간 이후 | 구 클러스터(/data/pgdata/17)와 롤백용 자료 정리, postgresql17 패키지 제거 |
사전 준비
업그레이드를 위해서 서비스 점검 이전에 수행해야 할 작업입니다.
호환성 및 변경점 확인
Patroni는 4.0.7버전 부터 PostgreSQL 18버전을 지원합니다. 3대 모두에서 현재 버전을 확인하고, 낮다면 업그레이드 작업과 분리해서 먼저 업그레이드합니다.
patroni --version
만약 버전이 4.0.7버전보다 낮다면 다음 명령으로 업그레이드합니다.
pip3 install --upgrade 'patroni[etcd3]'
sudo systemctl restart patroni
Patroni 재시작은 Replica부터 한 대씩 진행하고, 마지막에 Leader를 처리할 때는 switchover로 Leader를 옮긴 뒤 재시작합니다. 작업이 끝난 뒤 Leader가 2번 또는 3번에 위치할수 있으므로 운영정책에 따라서 다시 한번 더 Switch-over를 수행해서 Leader를 1번으로 변경합니다.
etcd는 이 작업에서 변경하지 않지만, Patroni 공식 절차에서 DCS 정리를 수행해야 하므로 업그레이드 내내 3대 모두 정상인지 확인합니다.
PostgreSQL 18버전에서 달라지는 항목이나 파라미터 등에 대해서 확인을 합니다. 아래는 확인 사항중 일부입니다.
| 항목 | 영향과 확인 방법 |
| initdb의 data checksums 기본활성화 | pg_upgrade는 구·신 클러스터의 checksum 설정이 같아야 합니다. 17 클러스터는 --data-checksums로 만들었으므로 18도 활성화해서 맞춥니다. |
| 최적화 통계 보존 | pg_upgrade가 통계를 이전합니다. 확장 통계(CREATE STATISTICS)는 이전되지 않으므로 업그레이드 후 다시 생성해야 합니다. |
| MD5 인증 deprecated | scram-sha-256을 사용한다면 영향이 없습니다. MD5 비밀번호 role이 남아 있는지는 확인합니다. |
| unlogged partitioned table 금지 | 있으면 업그레이드 전에 변경해야 합니다. |
| 전문 검색, pg_trgm 인덱스 | 기본 collation provider가 libc가 아닌 클러스터(ICU, builtin 등)는 전문 검색과 pg_trgm의 동작이 바뀔 수 있어 업그레이드 후 관련 인덱스를 reindex하는 것이 권장됩니다. |
| pg_stat_wal 등 통계 뷰 변경 | 컬럼이 제거되거나 바뀐 뷰가 있어 모니터링 쿼리를 사용 중이라면 점검합니다. |
통계 뷰에서 달라지는 항목은 다음과 같습니다. 해당 컬럼을 조회하는 모니터링 쿼리나 대시보드가 있다면 점검합니다.
- pg_stat_wal
- 변경: wal_write, wal_sync, wal_write_time, wal_sync_time 컬럼이 제거됩니다.
- 영향: 이 컬럼을 조회하는 모니터링 쿼리에서 에러가 발생합니다.
- pg_stat_io
- 변경: op_bytes 컬럼이 제거되고, read_bytes, write_bytes, extend_bytes 컬럼과 WAL I/O 행이 추가됩니다.
- 영향: op_bytes를 쓰는 쿼리에서 에러가 발생합니다.
- pg_backend_memory_contexts
- 변경: parent 컬럼이 제거되고, level이 0 기준에서 1 기준으로 바뀝니다.
- 영향: parent를 쓰는 쿼리에서 에러가 발생하고, level을 비교하는 쿼리는 결과 값이 달라집니다.
checksum 설정과 확장 목록은 현재 Leader에서 확인합니다.
/usr/pgsql-17/bin/pg_controldata /data/pgdata/17 | grep -i checksum
조회결과에서 Data page checksum version이 1이면 활성화된 것입니다.
PostgreSQL 18 패키지 설치
PGDG 저장소는 이미 등록되어 있으므로 PostgreSQL 18버전 패키지만 추가로 설치하며 3대 서버 공통으로 설치를 진행합니다. 17버전과 18버전은 /usr/pgsql-17, /usr/pgsql-18로 나뉘어 설치되어 공존하며, pg_upgrade는 구 버전 바이너리도 사용하므로 17버전 패키지는 제거하지 않습니다. pg_upgrade는 postgresql18-contrib 패키지에 포함되어 있습니다.
sudo dnf install -y postgresql18-server postgresql18-contrib
ls /usr/pgsql-18/bin/pg_upgrade
위와 같이 설치를 할 경우 특정 마이너 버전을 지정하지 않을 경우 저장소의 최신 18 마이너 버전이 설치됩니다.
마이너 버전을 직접 선택해서 설치할 수도 있습니다. 먼저 저장소에서 설치 가능한 버전을 조회합니다.
dnf --showduplicates list postgresql18-server postgresql18-contrib postgresql18-libs
버전은 18.7-1PGDG.rhel9.8 처럼 표시됩니다. 18.7이 마이너 버전이고, 뒤의 1PGDG는 패키지 릴리스, rhel9.8은 빌드 대상 OS 버전입니다.
같은 마이너 버전이 rhel9.6, rhel9.7, rhel9.8로 여러 개 보일 수 있으므로 서버의 OS 버전과 맞는 빌드를 선택합니다. 선택한 버전의 전체 문자열을 server, contrib, libs 세 패키지에 같게 지정해서 설치합니다.
sudo dnf install -y \
  postgresql18-server-18.7-1PGDG.rhel9.8 \
  postgresql18-contrib-18.7-1PGDG.rhel9.8 \
  postgresql18-libs-18.7-1PGDG.rhel9.8
/usr/pgsql-18/bin/postgres --version
3개 서버는 같은 마이너 버전이어야 하므로 설치 후 rpm -qa | grep postgresql18 결과가 3대에서 같은지 확인합니다.
버전을 지정하지 않고 3개 서버에서 서로 다른 날 설치하면 그 사이에 저장소에 새 마이너 버전이 올라와 서로 다른 버전이 설치될 수 있습니다.
PostgreSQL 서비스는 계속 Patroni가 시작하므로, 이 서비스들을 직접 시작하거나 자동 시작(enable)으로 설정하지 않습니다. 다음 명령으로 두 서비스가 모두 disabled인지 확인합니다.
systemctl is-enabled postgresql-17 postgresql-18

# 예상결과
disabled
disabled
새로운 버전의 바이너리 패키지가 설치가 되었다면 다음과 같이 모든 서버에서 다음과 같이 디렉토리를 생성합니다.
sudo mkdir -p /data/pgdata/18
sudo chown postgres:postgres /data/pgdata/18
sudo chmod 700 /data/pgdata/18
initdb 수행(Leader 인스턴스)
pg_upgrade를 실행하려면 먼저 새 버전(18) 클러스터가 먼저 생성되어 있어야 합니다. 구 클러스터(17)의 정의와 데이터를 옮겨 올 빈 클러스터를 initdb로 초기화하며, 이 클러스터를 직접 시작할 필요는 없습니다. initdb는 pg_upgrade를 실행할 pg_server1(Leader)에서만 수행합니다.
pg_upgrade는 구 클러스터의 role과 테이블 정의(스키마)를 덤프하여 새 클러스터에 복원하고, 데이터 파일은 선택한 방식(--copy 등)으로 새 클러스터의 데이터 디렉터리에 옮깁니다. 복원할 대상이 되는 새 클러스터가 있어야 하므로 initdb를 먼저 수행합니다.
계속 설명한 내용과 같이 initdb 수행 직후 모습 즉, 새 클러스터는 빈 상태여야 합니다. 설치 사용자(postgres) 외의 role, 데이터베이스, 테이블, 확장을 추가하면 pg_upgrade 검사에서 실패하므로 initdb 이후에는 아무것도 추가하지 않습니다.
pg_server2와 pg_server3은 pg_upgrade를 실행하지 않으므로 initdb를 수행하지 않고, 업그레이드한 Leader에서 Patroni가 복제하여 채웁니다.
pg_upgrade는 구 클러스터의 role 정보를 그대로 복원하므로 initdb에서 --pwprompt는 사용하지 않습니다.
sudo -u postgres /usr/pgsql-18/bin/initdb \
    -D /data/pgdata/18 \
    --username=postgres \
    --encoding=UTF8 \
    --locale=C \
    --auth-local=peer \
    --auth-host=scram-sha-256 \
    --data-checksums \
    -c log_directory=/data/pglog \
    -c logging_collector=on \
    -c wal_level=logical \
    -c wal_log_hints=on

# 생성후 디렉토리 조회
ls -al /data/pgdata/18
-c 옵션은 지정한 값을 initdb 중에 적용하고 생성되는 postgresql.conf에도 기록합니다. 새 클러스터도 17 버전 클러스터와 같은 위치(/data/pglog)에 로그를 저장하고 wal_level과 wal_log_hints가 같은 값이 되도록 지정합니다.
이 postgresql.conf는 Patroni가 시작하면 Patroni가 새로 작성한 파일로 대체되며, 이후 실제로 적용되는 값은 설정 파일 적용에서 복사하는 17 버전의 postgresql.base.conf와 DCS의 값입니다.
옵션은 이전 버전 클러스터를 생성할 때 사용한 값과 같아야 합니다. 특히 checksum 설정이 다르면 pg_upgrade 검사에서 실패합니다. 18 버전의 initdb는 checksum이 기본으로 활성화되므로, 이전 버전이 checksum 없이 생성되었다면 --no-data-checksums를 지정해야 합니다.
사전 백업
서비스 점거 후 업그레이드 과정에서 Patroni 관련 비교할 기준 정보를 미리 백업합니다.
sudo mkdir -p /tmp/pg_17_pg_upgrade_backup
patronictl -c /etc/patroni/patroni.yml list | sudo tee /tmp/pg_17_pg_upgrade_backup/patronictl_list_before.txt
patronictl -c /etc/patroni/patroni.yml show-config | sudo tee /tmp/pg_17_pg_upgrade_backup/patroni_dcs_config_before.yml
sudo cp -p /etc/patroni/patroni.yml /tmp/pg_17_pg_upgrade_backup/patroni.yml.$(hostname)
patroni.yml은 3대 모두에서 백업합니다. DCS 설정 저장은 뒤에서 DCS를 정리한 후 설정이 그대로 복원되었는지 비교하기 위한 것입니다.
그 다음으로 업그레이드 전에 복구 가능한 전체 백업을 확보합니다. 이 글은 pg_basebackup 예시를 사용하지만 스냅샷이나 기존 백업 체계를 사용해도 됩니다. 백업은 복구가 되는지까지 확인해야 의미가 있습니다.
/usr/pgsql-17/bin/pg_basebackup \
    -h 192.168.56.3 -U replicator \
    -D /tmp/pg_17_pg_upgrade_backup/basebackup_pg17 \
    -Ft -z -Xs -P
role과 권한 같은 전역 정보는 별도로 저장합니다. 이 파일은 전체 백업을 대체하지 않습니다.
/usr/pgsql-17/bin/pg_dumpall --globals-only > /tmp/pg_17_pg_upgrade_backup/globals_pg17.sql
pg_upgrade 사전 검사
pg_upgrade의 --check 옵션은 실제 변경 없이 구 클러스터와 새로운 클러스터의 호환성만 검사합니다. Leader가 실행 중인 상태에서 수행할 수 있으므로 이 단계는 서비스 중단 없이 진행됩니다. 구 클러스터가 실행 중이면 pg_upgrade는 postmaster.pid에서 포트와 소켓 위치를 읽어 접속합니다.
파일 처리 방식을 지정하는 옵션과 함께 실행해야 그 방식에 맞는 검사가 활성화됩니다. 그래서 사전 검사에도 실제 업그레이드에서 쓸 파일 처리 방식을 똑같이 지정합니다.
UPGRADE_MODE=--copy    # XFS reflink 환경이면 --clone, 시간이 문제라면 --link

sudo -u postgres bash -c "cd /var/lib/pgsql && /usr/pgsql-18/bin/pg_upgrade \
    --old-datadir=/data/pgdata/17 \
    --new-datadir=/data/pgdata/18 \
    --old-bindir=/usr/pgsql-17/bin \
    --new-bindir=/usr/pgsql-18/bin \
    --jobs=4 \
    ${UPGRADE_MODE} \
    --check"
pg_upgrade는 현재 디렉터리에 임시 소켓을 만들기 때문에 postgres 계정이 쓸 수 있는 디렉터리에서 실행합니다. 마지막에 Clusters are compatible이 출력되어야 하며, 오류가 있거나 안내된 후속 조치가 남아 있으면 해결한 뒤 다시 검사합니다. --link를 선택했다면 구·신 데이터 디렉터리가 같은 파일 시스템에 있어야 합니다.
새로운 버전용 Patroni 설정 준비
새로운(업그레이드 되는) 버전에 맞게 다음과 같이 3개 서버에서 patroni.yml의 data_dir과 bin_dir만 바꿉니다. 서비스 점검 후 업그레이드시 바로 교체할 수 있도록 새로운 버전 파일을 미리 만들어 둡니다. 아직 /etc/patroni/patroni.yml을 교체하지 않습니다.
# 3대 공통
sudo sed -e 's#data_dir: /data/pgdata/17#data_dir: /data/pgdata/18#' \
         -e 's#bin_dir: /usr/pgsql-17/bin#bin_dir: /usr/pgsql-18/bin#' \
         /etc/patroni/patroni.yml | sudo tee /etc/patroni/patroni.yml.pg18 > /dev/null

diff /etc/patroni/patroni.yml /etc/patroni/patroni.yml.pg18
diff 결과에 data_dir과 bin_dir 두 줄만 나와야 합니다.
업그레이드
이제 PostgreSQL 클러스터 업그레이드를 수행합니다.
애플리케이션 쓰기 차단
애플리케이션을 정상종료 하며 서비스를 정지하면서 데이터의 쓰기 시점을 마무리 할 수도 있으며 다음과 같이 PgBouncer는 관리 콘솔에서 데이터베이스(alias) 단위로 접속을 제어할 수 있습니다.
- DISABLE: 해당 alias로 들어오는 새 클라이언트 접속을 거부합니다. 접속을 시도한 클라이언트는 에러를 받습니다. 이미 연결된 세션은 끊기지 않습니다.
- KILL: 해당 alias의 클라이언트와 서버 연결을 즉시 끊습니다. 이후 새 접속은 RESUME을 실행할 때까지 대기합니다.
- ENABLE, RESUME: 각각 DISABLE, KILL을 해제합니다.
PgBouncer 2대에서 모두 DISABLE을 실행해 새 접속을 막습니다. 다음의 -U postgres 계정은 /etc/pgbouncer/pgbouncer.ini 의 admin_users 에서 지정한 PgBouncer 관리자 계정을 의미합니다.
# 데이터베이스 상태 확인
psql -h /tmp -p 6432 -U postgres pgbouncer -c "SHOW DATABASES;"

# pgbouncer_server1, pgbouncer_server2 각각
psql -h /tmp -p 6432 -U postgres pgbouncer -c "DISABLE postgres_write;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "DISABLE postgres_read;"

# 데이터베이스 상태 확인
psql -h /tmp -p 6432 -U postgres pgbouncer -c "SHOW DATABASES;"

      name      |       host       | port | database  |          | disabled
----------------+------------------+------+-----------+          +----------
 pgbouncer      |                  | 6432 | pgbouncer |  중간 생략 |        0
 postgres_read  | /var/run/haproxy | 5433 | postgres  |          |        1
 postgres_write | /var/run/haproxy | 5432 | postgres  |          |        1
DISABLE 후에 조회를 해보면 disabled 컬럼에 1로 설정된 것을 확인 할 수 있습니다.
다음과 같이 VIP로 접속하여 PgBouncer를 통해 접속이 되는지 확인해보면 database 가 disabled 라서 접속이 불가능함을 확인할 수 있습니다.
# VIP 경로
psql -h 192.168.56.8 -p 6432 -U postgres postgres_write -c "SELECT 1;"
psql -h 192.168.56.8 -p 6432 -U postgres postgres_read  -c "SELECT 1;"

psql -h 192.168.56.9 -p 6432 -U postgres postgres_write -c "SELECT 1;"
psql -h 192.168.56.9 -p 6432 -U postgres postgres_read  -c "SELECT 1;"


# 결과
psql: error: connection to server at "192.168.56.x", port 6432 failed: FATAL:  database "postgres_write" is disabled
psql: error: connection to server at "192.168.56.x", port 6432 failed: FATAL:  database "postgres_read" is disabled
DISABLE은 이미 연결된 세션을 끊지 않으므로 바로 이어서 KILL을 실행해 남아 있는 연결을 모두 종료합니다.
KILL은 해당 데이터베이스의 클라이언트와 서버 연결을 즉시 끊으므로 진행 중이던 트랜잭션은 완료되지 않습니다. 새 접속은 DISABLE로 이미 막혀 있으므로, 끊긴 애플리케이션이 다시 접속해도 PgBouncer로는 들어오지 못합니다.
psql -h /tmp -p 6432 -U postgres pgbouncer -c "KILL postgres_write;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "KILL postgres_read;"
SHOW POOLS로 연결이 모두 끊겼는지 확인합니다. sv_active, cl_active, cl_waiting이 모두 0이어야 합니다.
psql -h /tmp -p 6432 -U postgres pgbouncer -c "SHOW POOLS;"
변경 사항 반영 확인
쓰기가 차단되었으므로 이 시점의 WAL 위치가 업그레이드 전 데이터의 마지막 위치가 됩니다. Leader에서 이 값을 조회해 기록해 둡니다. 이후 단계에서 이 값을 L이라고 부르며, 아래 예시에서는 0/C0001E0이 Last LSN입니다.
-- pg_server1
SELECT pg_current_wal_lsn();

 pg_current_wal_lsn
--------------------
 0/C0001E0
(1 row)

* 값은 예시입니다.
pg_server2와 pg_server3에서 pg_last_wal_replay_lsn() 값을 조회해, Leader의 마지막 변경(L)까지 반영했는지 확인합니다. 두 노드 모두 L과 같거나 커야 하고, L보다 작으면 아직 따라오지 못한 것이므로 Last LSN 이상이 될 때까지 다시 조회합니다.
-- pg_server2, pg_server3
SELECT pg_is_in_recovery(), pg_last_wal_replay_lsn();

 pg_is_in_recovery | pg_last_wal_replay_lsn
-------------------+------------------------
 t                 | 0/C0001E0
(1 row)

* 값은 예시입니다.
Patroni 중지
이제 업그레이드를 위해 Patroni를 중지하겠습니다. Patroni를 중지하면 PostgreSQL도 함께 중지됩니다. 그 전에, 3번 인스턴스가 Logical Replication의 Publisher로서 Logical Slot을 보유한 상태에서 업그레이드를 진행하는 시나리오를 만들기 위해, 3번 인스턴스에서만 Logical Slot을 생성하겠습니다.
SELECT pg_create_logical_replication_slot('dr_sub', 'pgoutput');

SELECT slot_name, plugin, slot_type, database, active, conflicting,
       wal_status, restart_lsn, confirmed_flush_lsn
FROM pg_replication_slots
WHERE slot_name = 'dr_sub';
Replica를 먼저 중지하고 Leader를 마지막에 중지합니다. Leader를 먼저 중지하면 남은 Replica 중 하나가 새 Leader로 승격될 수 있습니다. etcd는 중지하지 않습니다.
# 1) pg_server3
sudo systemctl stop patroni

# 2) pg_server2
sudo systemctl stop patroni

# 3) pg_server1 (Leader, 마지막)
sudo systemctl stop patroni
세 노드 모두 PostgreSQL 프로세스가 없는지 확인합니다.
ps -ef | grep '[p]ostgres'
pg_upgrade 실행 (pg_server1)
다음과 같이 업그레이드를 수행합니다. 아래에서 --username=postgres 는 이 글의 테스트 환경에서 사용하는 PostgreSQL 클러스터의 superuser 입니다. 실제 작업 시에는 각 환경의 슈퍼유저명에 맞게 변경하여 사용합니다.
UPGRADE_MODE=--copy

sudo -u postgres bash -c "cd /var/lib/pgsql && /usr/pgsql-18/bin/pg_upgrade \
--username=postgres \
--old-datadir=/data/pgdata/17 \
--new-datadir=/data/pgdata/18 \
--old-bindir=/usr/pgsql-17/bin \
--new-bindir=/usr/pgsql-18/bin \
--jobs=4 \
${UPGRADE_MODE}"
다음과 같이 Upgrade Complete가 출력되면 성공입니다.
Upgrade Complete
----------------
Some statistics are not transferred by pg_upgrade.
Once you start the new server, consider running these two commands:
    /usr/pgsql-18/bin/vacuumdb --all --analyze-in-stages --missing-stats-only
    /usr/pgsql-18/bin/vacuumdb --all --analyze-only
Running this script will delete the old cluster's data files:
    ./delete_old_cluster.sh
pg_upgrade가 정상적으로 끝나면 실행한 디렉터리(/var/lib/pgsql)에 구 클러스터를 삭제하는 스크립트 delete_old_cluster.sh가 생성됩니다. 업그레이드 후 갱신해야 할 확장이 있으면 update_extensions.sql도 함께 생성됩니다. Upgrade Complete 메세지 화면에서 내용을 확인하거나 다음과 같이 디렉토리를 직접 조회합니다.
ls -alrt /var/lib/pgsql/
delete_old_cluster.sh는 구 클러스터를 삭제하는 스크립트이므로 지금 실행하지 않습니다. update_extensions.sql이 생성되었다면 새 Leader를 시작한 뒤에 실행합니다. update_extensions.sql 파일은 무조건 생성되는 것은 아닙니다.
새 클러스터는 이 단계에서 직접 시작하지 않습니다. 설정 파일을 적용한 뒤 Patroni를 시작하면 새 클러스터가 시작됩니다.
pg_upgrade가 실패하면 로그(new-datadir 아래 pg_upgrade_output.d)를 확인하고 원인을 해결합니다. --copy와 --clone은 구 클러스터가 변경되지 않으므로 그대로 다시 시도하거나 롤백할 수 있습니다. --link를 사용했다면 새 클러스터를 시작하기 전까지는 구 클러스터의 global/pg_control.old 파일 이름에서 .old를 제거하면 되돌릴 수 있고, 새 클러스터를 시작한 뒤에는 백업에서 복구해야 합니다.
설정 파일 적용(postgresql.conf, pg_hba.conf)
pg_upgrade는 구 클러스터(17 버전)의 데이터를 새 클러스터(18 버전)로 옮기지만 postgresql.conf와 pg_hba.conf 같은 설정 파일은 옮기지 않습니다. 새 클러스터의 데이터 디렉터리는 initdb가 생성한 기본 설정 파일로 시작하므로, 구 클러스터에서 사용하던 설정을 새 클러스터에 직접 적용해야 합니다.
PostgreSQL 문서도 업그레이드 후에 pg_hba.conf를 원래 설정으로 복원하고, 필요하면 postgresql.conf(포함된 파일 포함)와 postgresql.auto.conf를 구 클러스터에 맞게 조정하라고 안내합니다.
이 절의 설정 파일 적용은 pg_server1(Leader)에서만 합니다. pg_upgrade 실행이 끝난 뒤 Patroni로 새 클러스터를 시작하기 전에 적용합니다. pg_server2와 pg_server3(Replica)은 Replica 재구성으로 복제가 끝난 뒤에 적용하며, Replica의 새 데이터 디렉터리는 Patroni가 복제하여 채우므로 복제 전에는 비어 있어야 하기 때문입니다.
이 구성에서 설정은 다음 네 곳에 나뉘어 있습니다.
- postgresql.base.conf
- 내용: 직접 수정한 설정과 initdb 샘플 값
- 새 클러스터 적용 방법: 구 클러스터의 파일을 새 클러스터의 postgresql.base.conf로 복사합니다.
- postgresql.conf
- 내용: Patroni가 생성한 파일 (Patroni 관리 값)
새 클러스터 적용 방법: 복사하지 않습니다. initdb가 생성한 파일을 Patroni가 시작할 때 새로 작성합니다.
- 내용: Patroni가 생성한 파일 (Patroni 관리 값)
- postgresql.auto.conf
- 내용: ALTER SYSTEM으로 바꾼 설정
- 새 클러스터 적용 방법: 구 클러스터의 파일을 새 클러스터로 복사합니다. Replica는 복제를 구성한 뒤 각 노드의 파일을 복사합니다.
- DCS(etcd)
- 내용: patronictl edit-config로 지정한 값 (wal_level, wal_log_hints 등)
- 새 클러스터 적용 방법: patroni.dynamic.json 복사로 복원되며, Leader 시작 후 확인합니다.
Patroni는 PostgreSQL을 처음 시작할 때 postgresql.base.conf가 없으면 기존 postgresql.conf를 postgresql.base.conf로 이름을 변경하여 보존합니다. 그리고 첫 줄에 base 파일을 포함하는 설정을 쓰고, 그 아래에 자신이 관리하는 파라미터를 기록한 새 postgresql.conf를 작성합니다.
따라서 17버전의 postgresql.base.conf를 18버전으로 복사해 두면, Patroni는 이 파일을 그대로 두고 이 파일을 포함하는 새 postgresql.conf를 작성합니다. Patroni가 관리하는 파라미터를 제외한 설정은 복사한 파일의 값이 그대로 적용됩니다.
Patroni가 관리하는 파라미터(wal_level, max_connections 등)는 postgres 시작 인자로도 전달되어 설정 파일의 값보다 우선합니다. 설정 파일에 같은 파라미터가 적혀 있어도 실제로 적용되는 값은 DCS 값입니다.
구 클러스터의 postgresql.base.conf, postgresql.auto.conf, pg_hba.conf를 새 클러스터의 같은 이름 파일로 복사합니다.
postgresql.auto.conf는 구 클러스터의 파일을 그대로 복사합니다. ALTER SYSTEM으로 바꾼 설정이 있으면 함께 적용되고, 없으면 주석 줄만 있는 파일이므로 달라지는 것이 없습니다.
# pg_server1
sudo -u postgres cp -p /data/pgdata/17/postgresql.base.conf /data/pgdata/18/postgresql.base.conf
sudo -u postgres cp -p /data/pgdata/17/postgresql.auto.conf /data/pgdata/18/postgresql.auto.conf
sudo -u postgres cp -p /data/pgdata/17/pg_hba.conf /data/pgdata/18/pg_hba.conf
Patroni 설정 변경과 DCS 정리
지금까지 PostgreSQL 데이터 자체는 18버전으로 올렸지만, Patroni는 아직 이전 버전 기준으로 설정되어 있습니다. patroni.yml에는 bin_dir처럼 PostgreSQL 버전에 묶인 경로가 있고, DCS(etcd)에는 이전 클러스터의 상태 정보가 남아 있습니다.
이 상태로 Patroni를 기동하면 18버전이 아니라 이전 버전을 찾거나 이전 클러스터 정보를 기준으로 동작하게 됩니다. 그래서 기동 전에 설정 파일을 먼저 바꾸고 DCS를 정리해야 합니다. 먼저 3대 서버 모두에서 patroni.yml을 18버전용으로 교체합니다.
sudo cp -p /etc/patroni/patroni.yml /etc/patroni/patroni.yml.pg17
sudo cp -p /etc/patroni/patroni.yml.pg18 /etc/patroni/patroni.yml
grep -E 'data_dir|bin_dir' /etc/patroni/patroni.yml
DCS(etcd)에는 클러스터 상태가 저장되어 있고, 그 안의 initialize 키에는 클러스터의 system identifier가 기록되어 있습니다. pg_upgrade는 새 system identifier를 가진 클러스터를 만들기 때문에 DCS에 남아 있는 이전 클러스터의 initialize 키가 맞지 않게 됩니다.
그래서 Patroni 공식 절차에 따라 DCS의 클러스터 상태를 정리합니다. etcd는 실행 중이어야 하며, 아무 노드에서나 한 번만 실행합니다.
patronictl -c /etc/patroni/patroni.yml remove pg-cluster
+ Cluster: pg-cluster (7698785563610687538) ------+-----+------------+-----+
| Member | Host | Role | State | TL | Receive LSN | Lag | Replay LSN | Lag |
+--------+------+------+-------+----+-------------+-----+------------+-----+
+--------+------+------+-------+----+-------------+-----+------------+-----+
Please confirm the cluster name to remove: pg-cluster
You are about to remove all information in DCS for pg-cluster, please type: "Yes I am aware": Yes I am aware
먼저 삭제할 Cluster name 을 입력하고 난 다음에 정말 삭제를 진행할 것이라고 "Yes I am aware" 를 입력합니다.
이 명령은 DCS에 있는 해당 클러스터의 모든 정보를 삭제하므로 앞에서 저장한 설정 파일이 있는지 확인한 뒤 실행합니다. Patroni가 모두 중지되어 있어야 합니다.
patroni.yml을 18버전용으로 바꾸면 Patroni는 data_dir인 /data/pgdata/18 아래의 patroni.dynamic.json을 동적 설정을 캐시해 두는 파일로 사용합니다. 이 파일에는 wal_level 같은 동적 설정이 들어 있고, DCS를 정리한 뒤 Leader가 시작할 때 이 파일에서 설정을 복원합니다. 그런데 18버전 디렉터리에는 아직 이 파일이 없으므로 pg_server1에서 17버전의 파일을 복사합니다.
# pg_server1
sudo -u postgres cp -p /data/pgdata/17/patroni.dynamic.json /data/pgdata/18/patroni.dynamic.json
pg_server2와 pg_server3은 복사하지 않습니다. 두 노드의 18 디렉터리는 Replica 재구성을 위해 비어 있어야 하기 때문입니다.
Leader 시작 (pg_server1)
설정 파일 교체와 DCS 정리, patroni.dynamic.json 복사까지 끝났으므로 이제 pg_server1의 Patroni를 시작합니다.
sudo systemctl start patroni
sudo systemctl status patroni --no-pager
patronictl -c /etc/patroni/patroni.yml list
현재 진행 시나리오상 pg_server1이 Leader가 되어야 합니다. Patroni가 18버전 데이터 디렉터리를 기존 데이터로 인식해 새 클러스터로 등록합니다. 이후 다음을 확인합니다.
/usr/pgsql-18/bin/psql -h 192.168.56.3 -U postgres -c "SELECT version();"
curl -s -o /dev/null -w '%{http_code}\n' http://192.168.56.3:8008/primary
version이 18.x로 출력되고 /primary가 200을 반환해야 HAProxy가 이 노드를 Write 대상으로 인식합니다. DCS 설정이 업그레이드 전과 같은지 비교합니다.
patronictl -c /etc/patroni/patroni.yml show-config > /tmp/patroni_dcs_config_after.yml
diff /tmp/pg_17_pg_upgrade_backup/patroni_dcs_config_before.yml /tmp/patroni_dcs_config_after.yml
update_extensions.sql이 생성되었다면 이 시점에 실행합니다. 없다면 이 단계를 생략합니다.
sudo -u postgres /usr/pgsql-18/bin/psql -h 192.168.56.3 -U postgres -f /var/lib/pgsql/update_extensions.sql
Replica 재구성 (pg_server2, pg_server3)
Replica 노드에서는 pg_upgrade를 적용할 수 없습니다. 따라서 pg_server2와 pg_server3은 기존 데이터 디렉터리를 업그레이드하지 않고, 비어 있는 PostgreSQL 18버전 데이터 디렉터리에 Patroni가 Leader의 데이터를 다시 복제하도록 구성합니다.
앞에서 /data/pgdata/18을 비워 두었으므로 Patroni를 시작하면 DCS에서 pg_server1 Leader를 확인한 뒤 Base Backup으로 데이터를 구성하고 Replica로 참여해 WAL Streaming을 시작합니다. Base Backup을 수행하는 부하를 줄이기 위해 pg_server2를 먼저 완료한 뒤 pg_server3을 시작하는 것이 권장됩니다.
Replica에서 Patroni를 시작하면 patroni.yml의 DCS(etcd) 접속 정보로 이미 등록된 pg_server1 Leader를 찾습니다. 이어서 비어 있는 /data/pgdata/18을 감지하면 기본 Replica 생성 방식인 Base Backup을 실행하여 Leader 데이터를 받아 옵니다. Patroni가 Replica용 복구 설정을 구성하고 PostgreSQL을 시작하면 해당 노드는 DCS 멤버로 등록되고 WAL Streaming을 시작합니다.
따라서 이 단계에서는 사람이 pg_basebackup을 직접 실행하거나 PostgreSQL 서비스를 따로 시작할 필요가 없습니다. 단, patroni.yml의 복제 계정과 Leader의 pg_hba.conf 복제 접속 규칙이 올바르게 준비되어 있어야 합니다.
# pg_server2
sudo ls -A /data/pgdata/18        # 비어 있어야 합니다.
sudo systemctl start patroni
patronictl -c /etc/patroni/patroni.yml list
State가 streaming이 되고 Lag가 0이 되면 pg_server3에서도 같은 작업을 합니다.
# pg_server3
sudo ls -A /data/pgdata/18        # 비어 있어야 합니다.
sudo systemctl start patroni
patronictl -c /etc/patroni/patroni.yml list
3번 Replica 인스턴스가 시작되었다면 3번 서버에서 다음과 같이 dr_sub slot을 조회합니다. 예상하였던 대로 slot이 조회되지 않습니다. dr_sub slot은 3번 서버에만 있었고 1번 서버(Leader)에는 없었는데, Replica 재구성으로 3번 서버의 데이터 디렉터리가 Leader에서 새로 복제되어 채워졌기 때문입니다.
SELECT slot_name, plugin, slot_type, database, active, conflicting,
       wal_status, restart_lsn, confirmed_flush_lsn
FROM pg_replication_slots
WHERE slot_name = 'dr_sub';

 slot_name | plugin | slot_type | database | active | conflicting | wal_status | restart_lsn | confirmed_flush_lsn
-----------+--------+-----------+----------+--------+-------------+------------+-------------+---------------------
(0 rows)
이처럼 Replica에 logical slot을 두고 pg_upgrade로 업그레이드하는 환경에서는 업그레이드가 끝나면 slot이 반드시 사라집니다. pg_upgrade는 구 Standby에 있던 slot을 옮기지 않고, Replica는 Leader의 데이터를 새로 복제해서 구성하기 때문입니다.
slot이 없는 동안에는 DR DB로 전달되는 변경이 없으므로, 애플리케이션 쓰기를 재개하기 전에 slot을 다시 만들어야 합니다. 쓰기가 막혀 있는 상태에서 slot을 만들면 새 slot이 시작하는 위치 이전에는 전달할 변경이 없어 누락이 생기지 않습니다.
Replica 설정 파일 적용 (pg_server2, pg_server3)
두 Replica의 복제가 끝나면 Patroni를 중지하고, 구 클러스터의 설정 파일을 새 클러스터로 복사한 뒤 Patroni를 다시 시작합니다. Replica는 Leader의 데이터 디렉터리 전체를 복제하므로, 각 노드가 17버전에서 사용하던 pg_hba.conf와 postgresql.auto.conf는 복제가 끝나면 Leader의 18버전 파일로 대체됩니다.
Leader의 18버전 파일은 Leader의 17버전 파일을 복사한 것이어서 Leader 기준의 내용만 들어 있으므로, 노드마다 다르게 가지고 있던 설정은 복제 후 사라집니다. 그래서 각 노드의 17버전 파일을 18버전으로 복사하여 노드별 설정을 복원합니다.
# pg_server2
sudo systemctl stop patroni
sudo -u postgres cp -p /data/pgdata/17/postgresql.base.conf /data/pgdata/18/postgresql.base.conf
sudo -u postgres cp -p /data/pgdata/17/postgresql.auto.conf /data/pgdata/18/postgresql.auto.conf
sudo -u postgres cp -p /data/pgdata/17/pg_hba.conf /data/pgdata/18/pg_hba.conf
sudo systemctl start patroni
patronictl -c /etc/patroni/patroni.yml list

# pg_server3
sudo systemctl stop patroni
sudo -u postgres cp -p /data/pgdata/17/postgresql.base.conf /data/pgdata/18/postgresql.base.conf
sudo -u postgres cp -p /data/pgdata/17/postgresql.auto.conf /data/pgdata/18/postgresql.auto.conf
sudo -u postgres cp -p /data/pgdata/17/pg_hba.conf /data/pgdata/18/pg_hba.conf
sudo systemctl start patroni
patronictl -c /etc/patroni/patroni.yml list
통계 갱신
pg_upgrade는 최적화 통계를 이전하지만 확장 통계와 누적 통계는 이전하지 않습니다.
"--analyze-in-stages --missing-stats-only" 옵션은 없는 통계만 먼저 빠르게 만든 뒤 전체 ANALYZE를 수행합니다. --jobs로 병렬도를 높일 수 있습니다.
# pg_server1 (Leader)
/usr/pgsql-18/bin/vacuumdb --all --analyze-in-stages --missing-stats-only --jobs=4
"--analyze-only" 옵션은 전체 ANALYZE를 수행합니다. 서비스 재개 후에 수행해도 되며, 부하가 걱정되면 시간대를 조정해서 수행합니다.
/usr/pgsql-18/bin/vacuumdb --all --analyze-only --jobs=4
psql 로 PostgreSQL 클러스터에 접속하여 통계정보를 수집하고 싶다면 다음과 같이 수행합니다.
# 특정 데이터베이스에서만 통계정보 수집 수행
/usr/pgsql-18/bin/psql -U postgres -d postgres -c 'ANALYZE;'

# 모든 DB에 통계정보 수집 수행
/usr/pgsql-18/bin/psql -U postgres -d postgres -At \
-c "SELECT datname FROM pg_database WHERE datallowconn AND NOT datistemplate" |
while IFS= read -r db; do
    /usr/pgsql-18/bin/psql -U postgres -d "$db" \
    -v ON_ERROR_STOP=1 -c 'ANALYZE;'
done
서비스 재개
롤백 판단과 서비스 재개
업그레이드가 끝난 뒤 애플리케이션의 쓰기 트래픽을 다시 허용하기 전까지가 무손실 롤백 여부를 판단하는 마지막 시점입니다. 다만 --link는 새로운 18버전 클러스터를 시작하기 전까지만, --swap은 pg_upgrade의 파일 교체 단계가 진행되기 전까지만 구 클러스터를 그대로 사용할 수 있습니다.
서비스를 재개하기 전에 다음을 모두 확인합니다.
- patronictl list에서 3대가 정상이고 Leader는 pg_server1, 나머지는 streaming 상태입니다.
- 3대의 SELECT version() 결과가 모두 18.x입니다.
- Leader의 postgresql 로그에 오류가 없습니다.
- 주요 테이블과 확장, 애플리케이션 계정 접속이 정상입니다.
- Logical Replication 설정이 되어있을 경우 복제를 받는 DB에서 구독이 활성이고 Leader와 복제 DB의 대사 결과가 같습니다.
PostgreSQL 클러스터 상태 및 복제 상태 등이 정상이고 특이사항 없을 경우 서비스 재개를 결정합니다.
서비스 재개를 결정하였다면 PgBouncer 2대에서 접속을 다시 허용합니다. KILL은 RESUME으로, DISABLE은 ENABLE로 해제합니다.
SHOW DATABASES 에서 두 alias의 disabled와 paused가 모두 0이어야 합니다. VIP로 Write와 Read 경로를 확인합니다.
# pgbouncer_server1, pgbouncer_server2 각각
psql -h /tmp -p 6432 -U postgres pgbouncer -c "RESUME postgres_write;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "RESUME postgres_read;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "ENABLE postgres_write;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "ENABLE postgres_read;"
psql -h /tmp -p 6432 -U postgres pgbouncer -c "SHOW DATABASES;"
Write는 pg_is_in_recovery가 false이고, Read는 true여야 합니다. 서비스 재개 후에는 테스트 행 하나를 쓰고 Replica 노드와 복제 DB에 전달되는지 확인합니다.
psql -h 192.168.56.8 -p 6432 -U postgres postgres_write -c "SELECT version(), pg_is_in_recovery();"
psql -h 192.168.56.9 -p 6432 -U postgres postgres_read  -c "SELECT version(), pg_is_in_recovery();"
파일 처리 방식별 롤백 가능 범위
pg_upgrade의 파일 처리 방식에 따라 구버전 클러스터 데이터 파일이 보존되는 방식과 롤백 가능한 시점이 달라집니다.
| 방식 | pg_upgrade 완료 후, 신버전 인스턴스 시작 전 | 신버전 인스턴스 시작 후, 쓰기 재개 전 | 쓰기 재개 후 |
| --copy | 구 버전 데이터 파일이 그대로 남아 있으므로 롤백할 수 있습니다. | 신 버전을 중지한 뒤 구버전로 되돌릴 수 있습니다. | 구버전에는 재개 후 변경이 없으므로 무손실 롤백은 할 수 없습니다. |
| --clone | Copy-on-Write 복제본을 사용하므로 구 버전 데이터 파일이 그대로 남아 있습니다. | 신 버전을 중지한 뒤 구버전로 되돌릴 수 있습니다. | 구버전에는 재개 후 변경이 없으므로 무손실 롤백은 할 수 없습니다. |
| --link | 구 버전의 pg_control.old를 pg_control로 되돌린 뒤 구버전을 시작할 수 있습니다. | 신버전이 공유 데이터 파일에 쓸 수 있으므로 구버전 클러스터를 안전하게 시작할 수 없습니다. | 백업에서 복구해야 합니다. |
| --swap | 파일 교체가 진행된 뒤에는 구버전 클러스터가 이미 변경될 수 있습니다. | 간단한 롤백은 할 수 없으며 백업에서 복구해야 합니다. | 백업과 별도의 데이터 복구 계획이 필요합니다. |
--copy와 --clone은 새로운 버전 클러스터를 시작한 뒤에도 구버전 데이터 파일을 보존합니다. 반면 --link는 구·신 클러스터가 데이터 파일을 공유하므로 새로운 버전 클러스터를 시작한 뒤에는 구버전 클러스터를 사용할 수 없습니다. --swap은 pg_upgrade가 구버전 클러스터를 안전하게 시작할 수 없다고 알린 시점부터 백업 복구가 필요합니다.
Conclusion
이 글은 PostgreSQL HA 3부작의 마지막 글입니다. 세 편에서 다룬 내용을 이어서 정리하면 다음과 같습니다.
- 1부에서는 Patroni와 etcd로 PostgreSQL 3노드 HA 클러스터를 구성했습니다. Patroni가 Leader 선출과 failover를 관리하고, etcd가 클러스터의 상태와 설정을 저장합니다.
- 2부에서는 Client 측을 구성했습니다. keepalived의 VIP, PgBouncer의 연결 관리, HAProxy의 Leader와 Replica 구분을 통해 Leader가 바뀌어도 애플리케이션은 같은 주소로 접속합니다.
- 3부에서는 이렇게 구성한 환경에서 PostgreSQL 17을 18로 메이저 업그레이드했습니다.
HA 구성은 서버 장애에 대비한 구성이고, 메이저 버전 업그레이드까지 무중단으로 해 주지는 않습니다. 메이저 버전이 다르면 Streaming Replication이 되지 않으므로 Replica를 하나씩 올리는 롤링 방식을 쓸 수 없고, Leader에서 pg_upgrade를 수행한 뒤 Replica는 새 Leader에서 다시 복제받아야 합니다. 그래서 업그레이드에는 서비스 중단이 필요하며, 중단 시간은 pg_upgrade의 파일 처리 방식과 Replica 재구성에 걸리는 시간으로 정해집니다.
이 구성은 계층마다 맡는 일이 나뉘어 있어서 업그레이드 절차도 계층별로 나눠 진행할 수 있었습니다. 쓰기 차단은 PgBouncer에서, PostgreSQL 중지와 DCS 정리는 Patroni와 etcd에서 했고, VIP와 HAProxy, keepalived는 변경하지 않았습니다. 그래서 각 단계에서 작업하는 대상이 분명하고, 문제가 생겼을 때 롤백할 범위를 판단하기도 쉽습니다.
한 가지 더 중요한 점이 있습니다. 메이저 업그레이드에서 Replica 노드는 Leader로부터 백업을 받아 데이터를 동기화하는 방식으로 다시 구성됩니다. 이 때문에 글의 3번 노드가 가진 logical slot처럼 특정 Replica 노드에만 있던 구성은 재구성 과정에서 사라질 수 있습니다. 노드별로 다르게 구성한 부분이 있다면 업그레이드 전에 목록으로 정리해 두고, 업그레이드 이후에 다시 설정하고 확인해야 합니다.
여기서 글을 마무리 하도록 하겠습니다. 긴 글 읽어주셔서 감사합니다.
Reference
- PostgreSQL 18 pg_upgrade
- PostgreSQL 18 릴리스 노트
- PostgreSQL 18 Logical Replication 업그레이드
- PostgreSQL 18 Logical Decoding Concepts (Standby에서의 Logical Decoding)
- PostgreSQL 18 Streaming Replication Protocol
- PostgreSQL 18 CREATE SUBSCRIPTION
- Patroni, Major Upgrade of PostgreSQL Version
- Patroni Configuration
- Patroni Release Notes
- Patroni YAML Configuration (etcd3)
- etcd v3.7 업그레이드
- PgBouncer Admin Console
연관된 포스팅

Principal DBA(MySQL, AWS Aurora, Oracle)
핀테크 서비스인 핀다에서 데이터베이스를 운영하고 있어요(at finda.co.kr)
Previous - 당근마켓, 위메프, Oracle Korea ACS / Fedora Kor UserGroup 운영중
Database 외에도 NoSQL , Linux , Python, Cloud, Http/PHP CGI 등에도 관심이 있습니다
purityboy83@gmail.com / admin@hoing.io