Last Updated on 11월 10, 2026 by Jade(정현호)
안녕하세요
이번글은 PostgreSQL 고가용성 구성 2번째 글로 이전글에서 이어지는 글입니다.
PgBouncer / HAProxy / keepalived를 통한 PostgreSQL 접속 고가용성 개요
앞선 구성에서는 Patroni가 etcd에 저장된 클러스터 상태를 바탕으로 PostgreSQL 3대 클러스터의 Leader를 관리하고, 장애가 발생하면 Replica를 새 Leader로 승격하도록 구성했습니다. 그러나 애플리케이션이 장애가 난 PostgreSQL 노드나 접속 서버에 계속 연결하려 하면, 데이터베이스 클러스터가 정상적으로 Failover되어도 서비스 연결은 끊길 수 있습니다.
이번 구성에서는 애플리케이션과 PostgreSQL 클러스터 사이에 PgBouncer, HAProxy, keepalived를 둡니다. 이 계층은 PostgreSQL의 역할 전환을 감지해 접속을 올바른 노드로 전달하고, 접속을 받는 PgBouncer 서버 자체에 장애가 나도 VIP를 정상 서버로 옮겨 애플리케이션의 접속 지점을 유지합니다.
PgBouncer는 애플리케이션 연결을 받아 커넥션 풀링을 수행하고, postgres_write, postgres_read 가상 DB 이름으로 쓰기와 읽기 요청을 구분합니다.
같은 서버의 HAProxy는 Patroni REST API를 확인해 /primary가 정상인 Leader에는 쓰기 요청을, /replica가 정상인 Replica에는 읽기 요청을 전달합니다. Leader가 바뀌어도 애플리케이션이나 PgBouncer 설정을 변경하지 않고 새 Leader에 계속 접속할 수 있도록 지원합니다.
keepalived는 PgBouncer와 HAProxy가 함께 구성된 두 접속 서버의 VIP를 관리합니다. 한쪽 서버 또는 핵심 프로세스에 장애가 발생하면 VIP를 반대편 정상 서버로 이동시킵니다. 애플리케이션은 VIP 두 개만 접속 주소로 사용하므로, PostgreSQL Leader 전환이나 접속 서버 장애의 세부 구성을 알 필요가 없습니다.
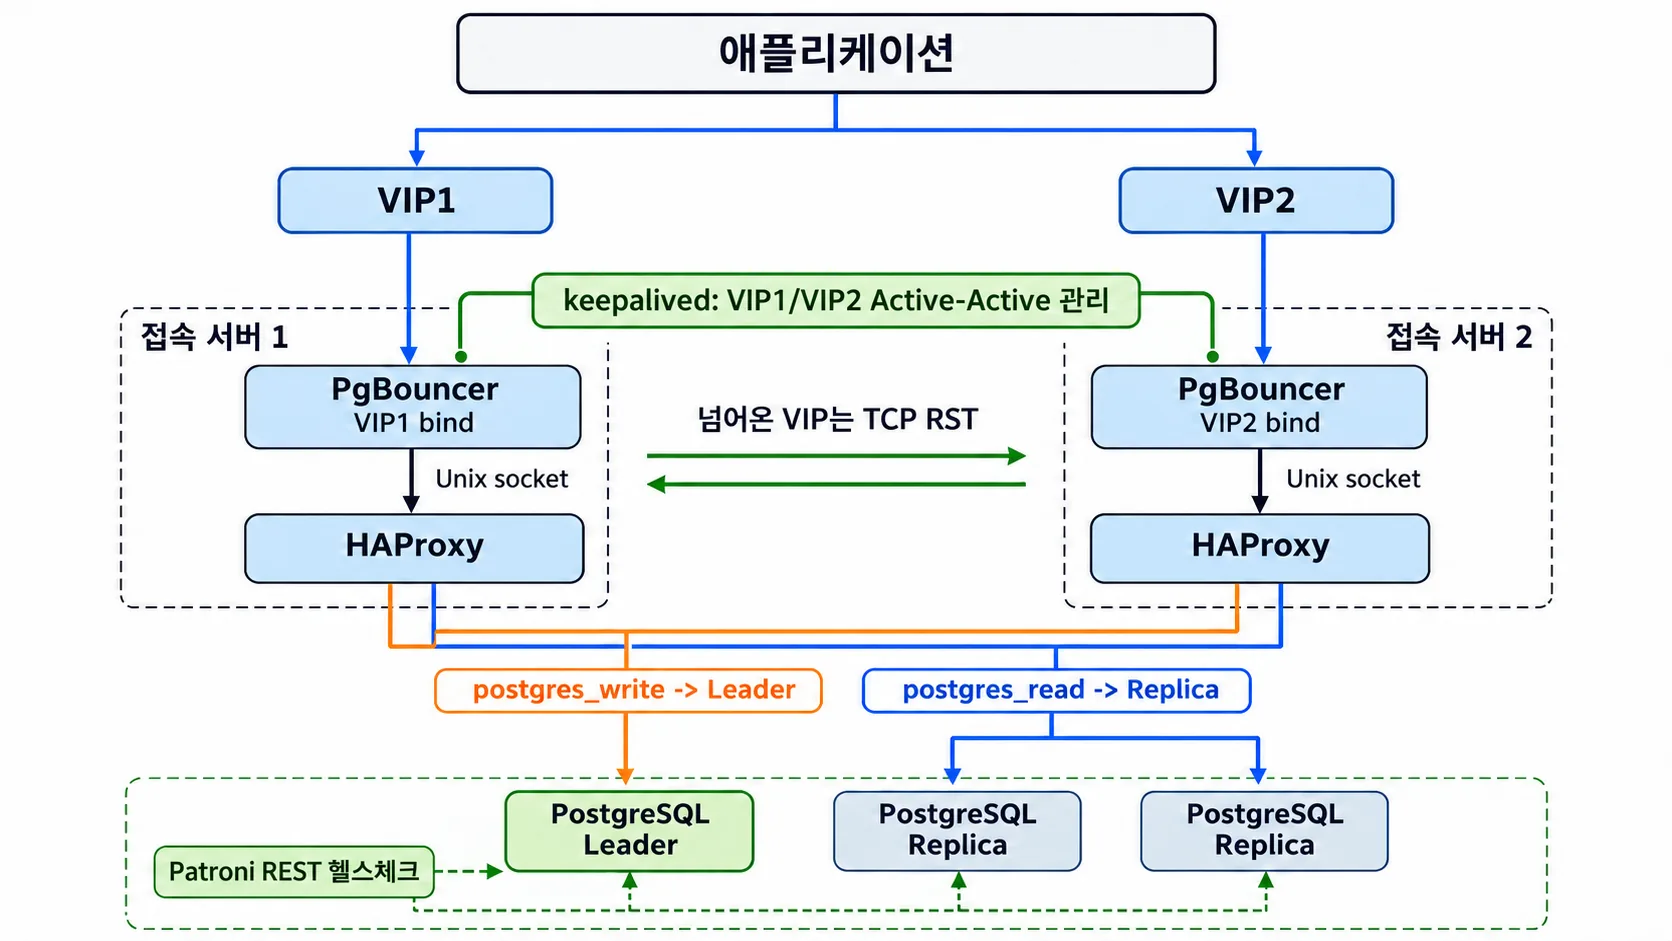
이 절에서는 PgBouncer, HAProxy, keepalived를 두 대의 접속 서버에 구성하고, Patroni PostgreSQL 3대 클러스터와 연결해 쓰기·읽기 분리, 접속 VIP Failover, 장애 복구 시 동작까지 구현합니다.
글의 환경 정보 및 네트워크 구성 정보는 이전글을 참조하시면 됩니다.
PgBouncer / HAProxy / keepalived 구성
net.ipv4.ip_nonlocal_bind 설정
리눅스는 기본적으로 어떤 IP에 bind하려면 그 IP가 지금 이 서버의 네트워크 인터페이스에 실제로 올라와 있어야 합니다. PgBouncer가 192.168.56.8/192.168.56.9 VIP로 직접 listen하려는데, 그 VIP가 지금 반대쪽 서버에 가 있는 상태라면 평소에는 bind 자체가 실패해서 PgBouncer가 시작하지 못합니다.
리눅스의 net.ipv4.ip_nonlocal_bind 파라미터는 현재 서버의 네트워크 인터페이스에 할당되지 않은 IP 주소에도 애플리케이션이 소켓을 bind할 수 있도록 허용하는 커널 파라미터입니다.
기본값은 0이며 0에서는 서버에 존재하지 않는 IP 주소로 bind할 수 없으며, 1로 설정하면 해당 IP 주소가 아직 할당되지 않은 상태에서도 수신 대기 소켓을 생성할 수 있습니다.
다음에 설명할 PgBouncer는 VIP 유무와 관계없이 시작하고 수신 대기 상태로 유지할 수 있으며, keepalived가 VIP를 이 서버로 옮기는 순간 이미 실행 중인 PgBouncer가 바로 트래픽을 받을 수 있습니다.
위의 내용과 같이 이 설정이 필요한 이유로 PgBouncer 시작시 VIP에 대한 의존성 및 순서지킴(시퀀스)에 대한 부분을 유연하게 하기 위해서 입니다.
파라미터가 활성화가 되어 있지 않다면 서비스를 시작하기전에 VIP가 존재하는지 체크하는 과정이나 또는 VIP가 네트워크 인터페이스에 할당될 때까지 대기해야 하며, 그에 따라서 순서를 지키는 로직이나 옵션을 추가적으로 고민해야합니다. 해당 파라미터를 1로 설정함으로 이러한 고려사항으로부터 제한사항이 사라지게 됩니다.
echo "net.ipv4.ip_nonlocal_bind = 1" | sudo tee -a /etc/sysctl.conf
grep net.ipv4.ip_nonlocal_bind /etc/sysctl.conf
sudo sysctl -p
설정 후 PgBouncer를 시작하면, VIP가 이 서버에 할당되거나 반대편 서버에서 failback으로 돌아오는 즉시 트래픽을 받을 수 있습니다.
keepalived
keepalived는 VRRP(Virtual Router Redundancy Protocol)를 사용하여 여러 서버가 하나 이상의 VIP를 관리할 수 있도록 지원하는 고가용성 솔루션입니다. 현재 VIP를 보유한 서버 또는 해당 서버의 핵심 서비스에 장애가 발생하면, 정상 서버가 VIP를 인계하여 클라이언트 접속 주소를 유지합니다.
이 구성에서는 PgBouncer와 HAProxy가 함께 구성된 두 접속 서버에서 keepalived를 사용합니다. keepalived는 PgBouncer와 HAProxy의 상태를 확인하고, 문제가 발생한 서버의 VIP를 반대편 접속 서버로 이동시킵니다. 애플리케이션은 PostgreSQL 서버의 실제 IP 주소가 아니라 VIP로 접속하므로, 접속 서버 장애 시에도 동일한 접속 주소를 사용할 수 있습니다.
VRRP의 동작 방식, keepalived의 MASTER/BACKUP 상태 전환, VIP 할당과 장애 조치 과정과 같은 보다 자세한 내용은 해당글을 참고하시면 됩니다.

keepalived 설치
설치는 현재 글에서 사용중인 rocky linux의 패키지 시스템을 통해서 다음과 같이 진행합니다.
sudo dnf install -y keepalived
keepalived 설정
VIP1과 VIP2는 각각 쓰기 또는 읽기 전용 주소가 아닙니다. 두 VIP 모두 PgBouncer 접속 주소로 사용할 수 있으며, 쓰기·읽기 구분은 애플리케이션이 요청하는 postgres_write 또는 postgres_read DB 이름으로 처리합니다. 따라서 keepalived 인스턴스도 역할명이 아니라 VIP 번호에 맞춰 VI_1과 VI_2로 지정합니다.
서버 1 전용과 서버 2로 나눠져 있으므로 구분해서 복사해야 합니다. 그리고 아래 네트워크 디바이스명을 변경 해야 합니다.
(글의 테스트 시스템 네트워크 디바이스는 enp0s9 이며 해당 기준으로 작성되어있으므로 실제 사용시 수정필요합니다.)
pgbouncer_server1 (VI_1 Active / VI_2 Standby)
sudo cp /etc/keepalived/keepalived.conf /etc/keepalived/keepalived.conf.bak_sample

sudo tee /etc/keepalived/keepalived.conf > /dev/null <<'EOF'
vrrp_script chk_pgbouncer {
    script "/usr/bin/killall -0 pgbouncer"
    interval 2
    weight -20
}

vrrp_script chk_haproxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2
    weight -20
}

vrrp_instance VI_1 {
    state MASTER
    interface enp0s9
    virtual_router_id 51
    priority 100
    advert_int 1
    unicast_src_ip 192.168.56.6
    unicast_peer { 192.168.56.7 }
    virtual_ipaddress { 192.168.56.8 }
    track_script {
        chk_pgbouncer
        chk_haproxy
    }
}

vrrp_instance VI_2 {
    state BACKUP
    interface enp0s9
    virtual_router_id 52
    priority 90
    advert_int 1
    unicast_src_ip 192.168.56.6
    unicast_peer { 192.168.56.7 }
    virtual_ipaddress { 192.168.56.9 }
    track_script {
        chk_pgbouncer
        chk_haproxy
    }
}
EOF
pgbouncer_server2 (VI_2 Active / VI_1 Standby)
sudo cp /etc/keepalived/keepalived.conf /etc/keepalived/keepalived.conf.bak_sample

sudo tee /etc/keepalived/keepalived.conf > /dev/null <<'EOF'
vrrp_script chk_pgbouncer {
    script "/usr/bin/killall -0 pgbouncer"
    interval 2
    weight -20
}

vrrp_script chk_haproxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2
    weight -20
}

vrrp_instance VI_1 {
    state BACKUP
    interface enp0s9
    virtual_router_id 51
    priority 90
    advert_int 1
    unicast_src_ip 192.168.56.7
    unicast_peer { 192.168.56.6 }
    virtual_ipaddress { 192.168.56.8 }
    track_script {
        chk_pgbouncer
        chk_haproxy
    }
}

vrrp_instance VI_2 {
    state MASTER
    interface enp0s9
    virtual_router_id 52
    priority 100
    advert_int 1
    unicast_src_ip 192.168.56.7
    unicast_peer { 192.168.56.6 }
    virtual_ipaddress { 192.168.56.9 }
    track_script {
        chk_pgbouncer
        chk_haproxy
    }
}
EOF
서버 1과 비교하면 unicast_src_ip/unicast_peer가 서로 뒤바뀌고(각자 자기 자신의 IP/상대방의 IP), VI_1과 VI_2의 priority·state가 반대로 되어 있습니다. 이렇게 하면 평상시 VI_1은 서버 1이, VI_2는 서버 2가 들고 있는 Active-Active 구조가 됩니다.
위의 설정은 PgBouncer와 HAProxy를 서로 독립적인 systemd 서비스로 두고, keepalived가 chk_pgbouncer와 chk_haproxy를 각각 확인합니다. 따라서 두 프로세스 중 하나라도 비정상 상태가 되면 해당 접속 서버의 priority가 낮아지고, VIP가 반대편 정상 서버로 이동합니다. 이 문서에서 실제로 적용하는 구성도 방식 A이며, 위 keepalived 설정의 chk_haproxy와 track_script의 chk_haproxy 항목을 그대로 유지합니다.
설정이 완료 되었다면 다음과 같이 활성화 및 확인합니다.
sudo systemctl enable --now keepalived

sudo systemctl status keepalived

sudo journalctl -u keepalived -n 50 --no-pager

sudo ip addr show
keepalived로 설정된 VIP는 ip addr show로 확인하는 것이 권장되며, ifconfig에서는 secondary IP가 표시되지 않을 수 있습니다.
PgBouncer
PgBouncer는 PostgreSQL 전용 경량 Connection Pooler로, 애플리케이션의 다수 연결을 PgBouncer가 대신 받아 실제 PostgreSQL 연결 수를 줄여주는 역할을 합니다. PostgreSQL은 Connection마다 Backend Process가 생성되기 때문에 연결 수가 많아질수록 메모리 사용량과 프로세스 관리 비용이 증가할 수 있는데, PgBouncer를 사용하면 애플리케이션 연결과 실제 DB 연결을 분리하여 이러한 부담을 줄일 수 있습니다.
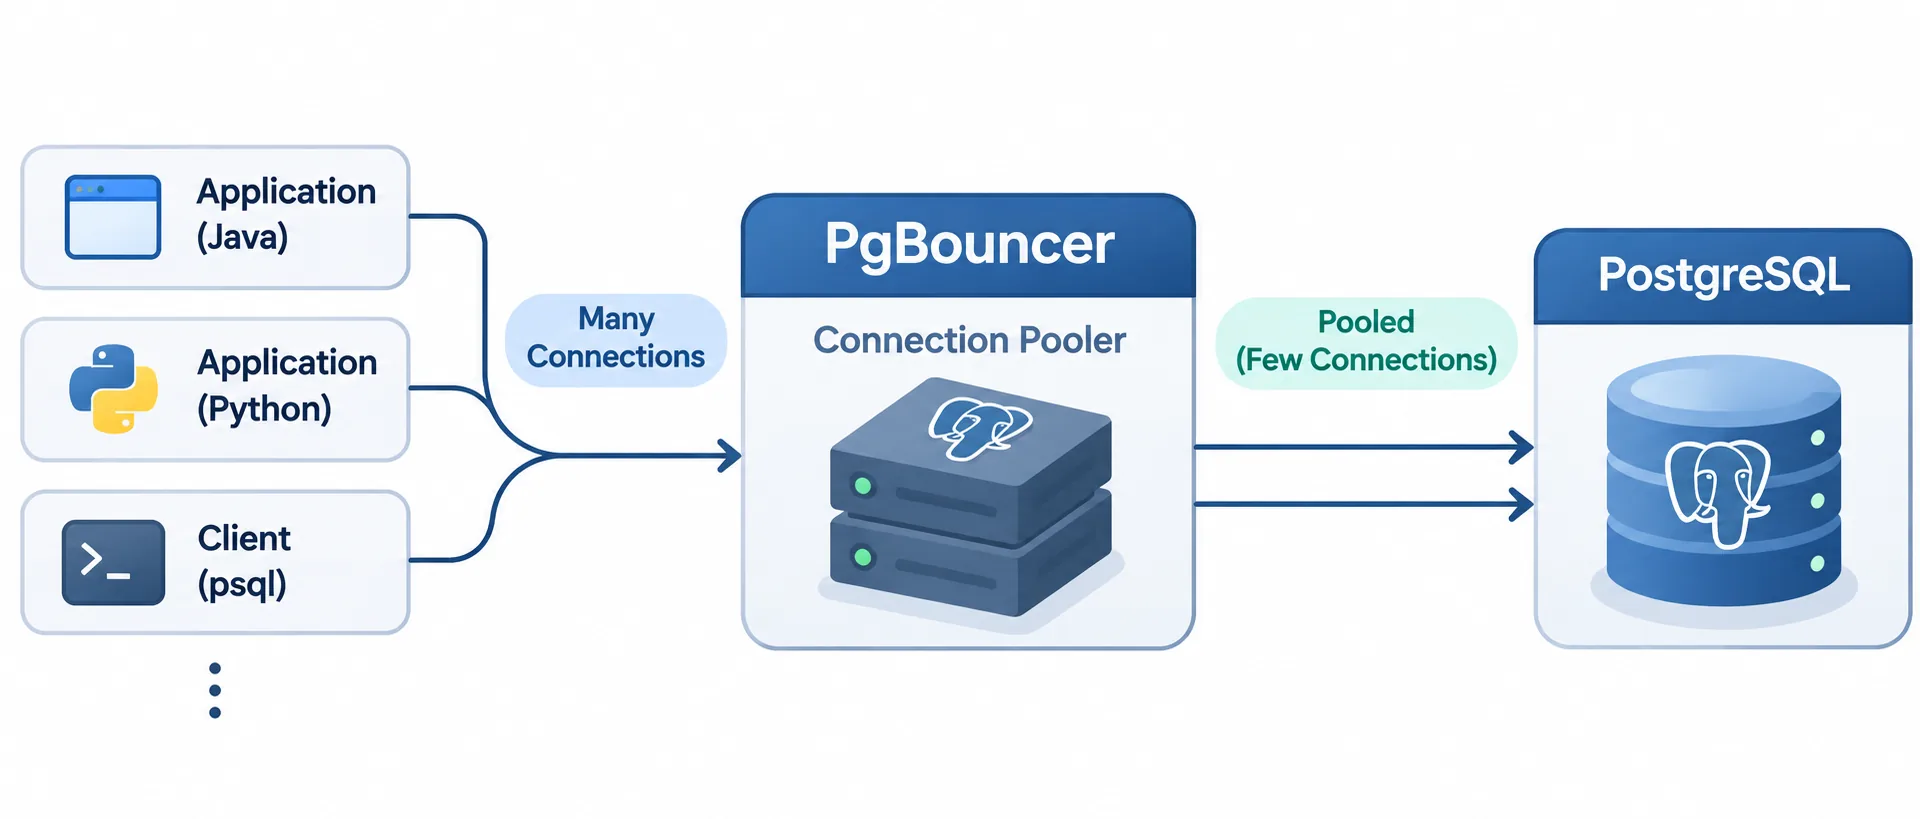
또한 Session, Transaction, Statement 단위의 Pooling 방식을 지원하며, 일반적으로는 Transaction Pooling을 많이 사용합니다. PgBouncer 자체는 데이터 복제나 Failover를 수행하지 않으며, 고가용성 환경에서는 HAProxy, Keepalived, Patroni 등의 구성과 함께 사용할 수 있습니다.
이번 구성에서는 PgBouncer의 listen_addr를 "*" 로 설정하지 않고 각 노드에 할당된 특정 VIP에만 Bind하도록 구성합니다. 장애가 발생하여 VIP가 다른 노드로 이동하더라도 해당 VIP로 실제 서비스를 인계받는 구조는 아니며, 이동된 VIP에서는 PgBouncer가 Listen하지 않도록 구성합니다.
이 VIP는 일반적인 Active/Standby 서비스 인계 목적이 아니라, 장애 Endpoint에 대한 빠른 접속 실패 감지를 위한 Fast Connection Failure Detection 용도로 사용합니다. 장애가 발생한 Endpoint에 대한 접속이 네트워크 Timeout까지 대기하지 않도록 하고, 다른 노드로 이동한 VIP에서 빠르게 접속 실패를 반환하여 Client가 다음 PgBouncer Endpoint로 신속하게 Failover할 수 있도록 합니다.
PgBouncer 설치
Rocky Linux 계열은 PGDG YUM/DNF 저장소를, Ubuntu/Debian 계열은 PGDG APT 저장소를 사용하여 PgBouncer 패키지를 설치할 수 있습니다. OS 기본 저장소보다 최신 PgBouncer 버전이 필요한 경우 PGDG 저장소 사용을 권장합니다.
글에서는 PGDG 저장소를 구성하여 진행하였습니다.
sudo dnf install -y pgbouncer
PgBouncer 설정
현재 테스트 시스템 구성에서 VIP는 192.168.56.8 와 192.168.56.9 입니다. VIP는 keepalived가 관리하며, PgBouncer가 직접 bind(HAProxy가 아님) 하게 됩니다. 두 VIP는 Write/Read 역할 구분이 없는 범용 진입점으로 사용합니다.
bind 하는 IP는 각 서버의 자기 VIP 하나만 명시적으로 설정하여 bind합니다. 서버 1은 192.168.56.8, 서버 2는 192.168.56.9 입니다. 다음 설정에서 다른 값은 listen_addr 이며 나머지 항목은 동일합니다
설정파일은 양쪽 서버 모두 같은 경로 및 파일이며 다음과 같습니다.
파일 경로 및 파일명: /etc/pgbouncer/pgbouncer.ini
pgbouncer_server1 (192.168.56.6)
[databases]
; 같은 서버 HAProxy, 유닉스 소켓
postgres_write = host=/var/run/haproxy port=5432 dbname=postgres
postgres_read  = host=/var/run/haproxy port=5433 dbname=postgres

[pgbouncer]
listen_addr = 192.168.56.8
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
pool_mode = transaction
max_client_conn = 100
default_pool_size = 20
logfile = /var/log/pgbouncer/pgbouncer.log
pidfile = /run/pgbouncer/pgbouncer.pid
admin_users = postgres
pgbouncer_server2 (192.168.56.7)
[databases]
; 같은 서버 HAProxy, 유닉스 소켓
postgres_write = host=/var/run/haproxy port=5432 dbname=postgres
postgres_read  = host=/var/run/haproxy port=5433 dbname=postgres

[pgbouncer]
listen_addr = 192.168.56.9
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
pool_mode = transaction
max_client_conn = 100
default_pool_size = 20
logfile = /var/log/pgbouncer/pgbouncer.log
pidfile = /run/pgbouncer/pgbouncer.pid
admin_users = postgres
위에서 PgBouncer 설정은 다음과 같은 의미를 가집니다.
PgBouncer 설정은 크게 클라이언트가 사용할 Database Alias와 실제 Backend 연결 정보를 정의하는 [databases] 영역, 그리고 PgBouncer 자체의 Connection Pooling 및 인증 방식을 정의하는 [pgbouncer] 영역으로 나뉩니다.
주요 설정에 대한 설명은 다음과 같습니다.
- postgres_write / postgres_read
- PgBouncer에서 사용하는 Database Alias입니다.
- 실제 PostgreSQL Database는 postgres이며, 각각 HAProxy의 5432/5433 포트로 연결하여 Write/Read 경로를 분리합니다.
- host=/var/run/haproxy
- PgBouncer와 HAProxy가 동일 서버에 있어 TCP 대신 Unix Domain Socket으로 연결합니다.
- listen_addr / listen_port
- PgBouncer가 클라이언트 연결을 받을 IP와 포트입니다. 클라이언트는 192.168.56.8:6432로 접속합니다.
- auth_type / auth_file
- 클라이언트 인증 방식으로 SCRAM-SHA-256을 사용하며, 사용자 인증정보는 userlist.txt에서 관리합니다.
- pool_mode=transaction
- Transaction이 종료되면 Backend Connection을 Pool로 반환하여 다른 Client가 재사용합니다.
- max_client_conn=100
- PgBouncer가 동시에 받을 수 있는 전체 Client Connection의 최대 수입니다.
- default_pool_size=20
- 기본적으로 Database/User 조합별로 사용할 수 있는 PostgreSQL Backend Connection Pool의 최대 크기입니다.
- admin_users=postgres
- PgBouncer Admin Console에 접속하여 SHOW POOLS, SHOW CLIENTS, SHOW SERVERS 등의 관리 명령을 사용할 수 있는 계정입니다.
Connection Pooling 동작
현재 설정은 max_client_conn=100, default_pool_size=20, pool_mode=transaction으로 구성되어 있습니다. 예를 들어 동일한 Database/User Pool에 100개의 Client가 동시에 Transaction을 요청하더라도 PostgreSQL Backend Connection은 최대 20개까지 사용하고, 나머지 Client는 사용 가능한 Backend Connection이 반환될 때까지 PgBouncer에서 대기합니다. Transaction이 COMMIT 또는 ROLLBACK되면 해당 Connection은 즉시 Pool로 반환되고 대기 중인 Client가 이어서 사용합니다.
Client Connections 최대 100
          |
          v
      PgBouncer
          |
          | Backend Pool 최대 20
          v
      PostgreSQL
단, default_pool_size=20은 PgBouncer 전체 Backend Connection을 20개로 제한한다는 의미가 아니라 Database/User 조합별 Pool에 적용되는 값입니다. 여러 Database Alias 또는 여러 User를 사용하면 각각 별도의 Pool이 생성될 수 있으므로 전체 PostgreSQL Connection 수는 20개를 초과할 수 있습니다.
Write / Read 연결 구조
이번 구성은 PgBouncer의 Database Alias를 단순한 별칭이 아니라 애플리케이션 관점의 논리적인 Write/Read Endpoint로 활용한 구조입니다. 애플리케이션에서는 실제 PostgreSQL 노드나 HAProxy 포트를 직접 관리할 필요 없이 postgres_write 또는 postgres_read만 선택하면 되므로 사용이 단순하고, Connection Pooling과 HA Routing의 역할도 명확하게 분리할 수 있습니다. 일반적인 PgBouncer 구성에서 흔히 볼 수 있는 형태는 아니며, 쓰기와 읽기 경로를 유연하게 분리할 수 있다는 점이 이번 구성의 특징입니다.
postgres_write와 postgres_read는 실제 PostgreSQL Database가 아니라 PgBouncer에서 정의한 Alias입니다. 클라이언트가 어떤 Alias로 접속하느냐에 따라 HAProxy의 서로 다른 포트로 전달되고, HAProxy가 실제 PostgreSQL Primary 또는 Replica로 연결합니다.
Client
  |
  v
PgBouncer :6432
  |
  +-- postgres_write -> HAProxy :5432 -> PostgreSQL Primary
  |
  +-- postgres_read  -> HAProxy :5433 -> PostgreSQL Replica
즉 PgBouncer는 Connection Pooling을 담당하고, 실제 Primary/Replica 선택과 Failover 처리는 HAProxy와 Patroni 계층에서 담당합니다.
PgBouncer 인증 사용자 파일 생성
auth_type을 scram-sha-256으로 설정했으므로 인증 사용자 파일도 함께 준비해야 합니다. 이 파일이 없어도 PgBouncer 프로세스 자체는 실행될 수 있지만, auth_file을 열 수 없다는 경고가 기록되며 클라이언트의 접속 인증은 모두 실패합니다. PostgreSQL에 SCRAM 형식으로 저장된 비밀번호 해시를 조회하여 이 파일에 그대로 등록합니다.
글에서는 username 에 postgres 로 조회하였지만 실제에서는 PgBouncer를 통해 접속할 애플리케이션이나 사용자 계정에 대한 정보를 조회해야합니다.
SELECT usename, passwd FROM pg_shadow WHERE usename='postgres';
조회된 SCRAM-SHA-256$…형태의 값을 pgbouncer_server1/2에서 다음 형식으로 작성합니다.
파일 경로 및 파일명은 pgbouncer.ini 의 auth_file 파라미터에 설정되어있습니다.
vi /etc/pgbouncer/userlist.txt

"postgres" "SCRAM-SHA-256$4096:<salt>$<StoredKey>:<ServerKey>"
파일을 생성하였다면 다음과 같이 PgBouncer를 시작합니다.
sudo systemctl enable --now pgbouncer

sudo systemctl status pgbouncer

sudo journalctl -u pgbouncer -n 50 --no-pager
HAProxy
HAProxy는 TCP/HTTP 기반의 Load Balancer이자 Proxy로, Backend 서버의 상태를 확인하고 정상 서버로 연결을 전달합니다.
이번 구성에서는 단순한 Load Balancing 용도로 사용하는 것이 아니라, Patroni가 제공하는 PostgreSQL 노드의 상태와 Role 정보를 기준으로 Primary(Writer)와 Replica(Reader)를 구분하여 각각 별도의 포트로 라우팅하도록 구성합니다. 이를 통해 애플리케이션이나 PgBouncer에서는 Writer/Reader 접속 경로만 구분하면 되고, 실제 PostgreSQL 노드가 변경되거나 Failover가 발생하더라도 접속 정보를 변경할 필요가 없습니다.
특히 HAProxy를 단순한 서버 분산 계층이 아니라 PostgreSQL의 Role을 인지하는 Routing 계층으로 활용한 점이 이번 구성의 특징이며, Write/Read 분리와 Failover 대응을 보다 단순하고 유연하게 구성할 수 있습니다.
HAProxy 설치
패키지 시스템을 통해 다음과 같이 설치합니다.
sudo dnf install -y haproxy
HAProxy 설정
/etc/haproxy/haproxy.cfg 파일에 2개 서버 동일하게 다음과 같이 설정합니다.
frontend pg_write_front
  mode tcp
  option tcplog
  bind /var/run/haproxy/.s.PGSQL.5432 mode 666
  default_backend pg_write_back

backend pg_write_back
  mode tcp
  option httpchk GET /primary
  http-check expect status 200
  server pg_server1 192.168.56.3:5432 check port 8008
  server pg_server2 192.168.56.4:5432 check port 8008
  server pg_server3 192.168.56.5:5432 check port 8008

frontend pg_read_front
  mode tcp
  option tcplog
  bind /var/run/haproxy/.s.PGSQL.5433 mode 666
  use_backend pg_read_primary_fallback if { nbsrv(pg_read_back) eq 0 }
  default_backend pg_read_back

backend pg_read_back
  mode tcp
  balance roundrobin
  option httpchk GET /replica
  http-check expect status 200
  server pg_server1 192.168.56.3:5432 check port 8008
  server pg_server2 192.168.56.4:5432 check port 8008
  server pg_server3 192.168.56.5:5432 check port 8008

backend pg_read_primary_fallback
  mode tcp
  option httpchk GET /primary
  http-check expect status 200
  server pg_server1 192.168.56.3:5432 check port 8008
  server pg_server2 192.168.56.4:5432 check port 8008
  server pg_server3 192.168.56.5:5432 check port 8008
설정이 완료되었다면 다음과 같이 문제가 없는지 체크를 합니다.
sudo haproxy -c -f /etc/haproxy/haproxy.cfg
체크시 몇 개의 warning이 발생할 수 있으나 공통 defaults의 option forwardfor가 PostgreSQL TCP 구간에도 상속되어 발생하는 경고입니다. HTTP 전용 옵션이라 TCP 연결에는 적용되지 않지만, HAProxy가 무시하고 경고만 기록합니다. PostgreSQL 연결과 Reader fallback 동작에는 영향이 없으므 로 별도 조치가 필요하지 않습니다.
HAProxy는 VIP가 아닌 로컬 유닉스 소켓에 bind합니다. PgBouncer는 host=/var/run/haproxy 및 포트 번호를 기준으로 정해진 .s.PGSQL.포트번호 소켓 파일에 접속하므로, HAProxy bind 경로와 포트는 PgBouncer 설정과 일치해야 합니다.
따라서 net.ipv4.ip_nonlocal_bind는 VIP를 직접 listen_addr로 사용하는 PgBouncer에만 필요합니다. HAProxy 소켓 디렉터리는 미리 생성하고, PgBouncer가 접속할 수 있도록 bind 설정에 mode 666을 지정합니다. 구성에서는 HAProxy를 단순한 Load Balancer가 아니라, Patroni가 제공하는 PostgreSQL 노드의 Role 정보를 기준으로 Writer와 Reader를 구분하는 Routing 계층으로 사용합니다.
Write 경로
Write 경로는 Patroni REST API의 /primary Endpoint를 Health Check하여 현재 Primary인 PostgreSQL 노드만 Backend로 사용합니다. heck port 8008을 통해 Patroni REST API를 별도로 확인합니다. Patroni에서 /primary 요청에 HTTP 200을 반환하는 노드가 현재 Primary이므로, Failover가 발생해 Primary가 변경되면 HAProxy도 자동으로 새로운 Primary로 연결을 전달합니다.
Read 경로
Patroni의 /replica Endpoint를 통해 Replica 상태인 노드만 Backend로 등록합니다. 여러 Replica가 정상 상태이면 roundrobin 방식으로 연결을 분산합니다.
이번 글에서 이부분이 매우 특별한 구성으로 아래 설정은 정상 Replica가 하나도 없는 경우를 대비한 Fallback 구성입니다.
use_backend pg_read_primary_fallback if { nbsrv(pg_read_back) eq 0 }
nbsrv(pg_read_back) 값이 0, 즉 사용 가능한 Replica가 없는 경우 pg_read_primary_fallback Backend로 전환하여 Primary로 Read Connection을 전달합니다. 이를 통해 모든 Replica 장애가 발생하더라도 Read Endpoint 자체가 즉시 사용할 수 없는 상태가 되는 것을 방지할 수 있습니다.
이와 같은 구성은 AWS Aurora에서 Cluster Reader Endpoint 로 접속시 Reader 인스턴스가 없는 구성 또는 접속이 불가능한 상황에서 Writer 인스턴스로 접속 처리가 되는 것과 동일한 구성이라고 할 수 있습니다.
정리하면 이번 HAProxy 구성은 다음과 같이 동작합니다.
| 경로 | Patroni Health Check | 연결 대상 |
| Write | /primary | 현재 Primary |
| Read | /replica | 정상 Replica, Round Robin |
| Read Fallback | /primary | 사용 가능한 Replica가 없을 경우 Primary |
/var/run은 tmpfs라 재부팅하면 사라지므로, 아래처럼 지금 당장 만드는 것과 재부팅 후에도 유지되게 하는 것 둘 다 필요합니다.
echo "d /var/run/haproxy 0755 root root -" | sudo tee /etc/tmpfiles.d/haproxy.conf
sudo systemd-tmpfiles --create /etc/tmpfiles.d/haproxy.conf
설정이 모두 완료 되었다면 다음과 같이 haproxy 서비스를 시작합니다.
sudo systemctl enable --now haproxy
sudo systemctl status haproxy

sudo journalctl -u haproxy -n 50 --no-pager
서비스의 특이사항이 없다면 다음과 같이 HAProxy Runtime API의 show stat 명령을 이용하여 각 Frontend/Backend와 Backend Server의 현재 상태(UP/DOWN)를 확인합니다.
echo "show stat" | sudo nc -U /var/lib/haproxy/stats | awk -F',' '{print $1","$2","$18}' | column -s',' -t
Architecture Design Overview
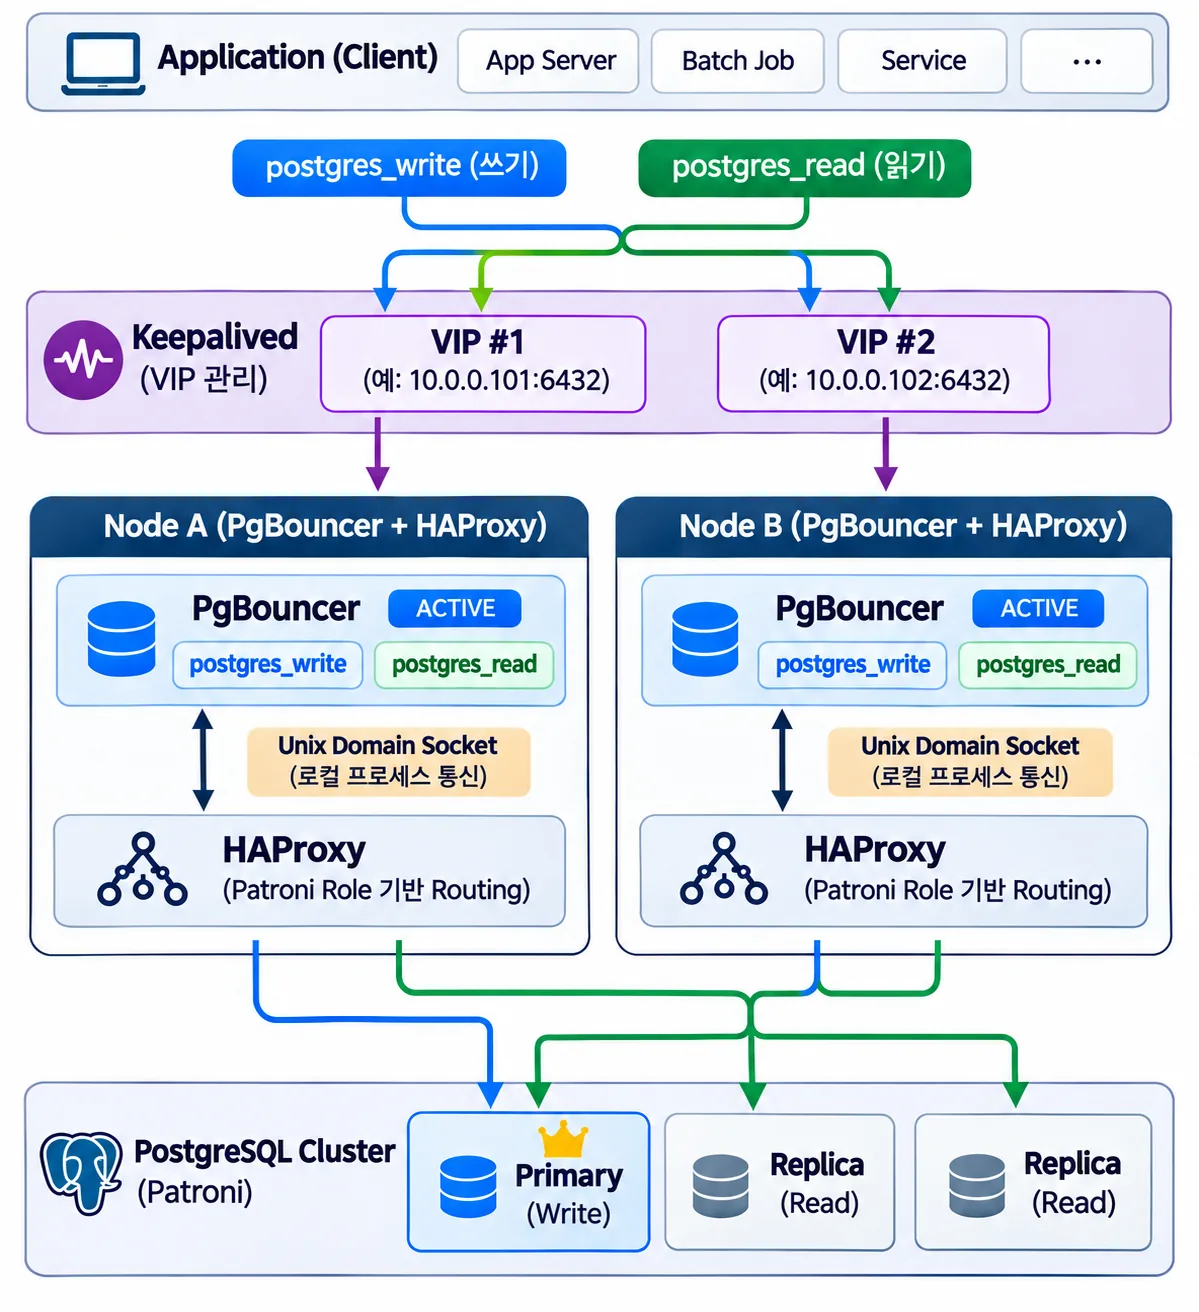
이번 구성은 PgBouncer, HAProxy, Keepalived를 각각 독립적으로 사용하는 것이 아니라, PostgreSQL로 접속하는 클라이언트 계층에서 각 구성요소의 역할을 분리하고 서로 연계하여 하나의 HA 구조로 구성한 것이 특징입니다.
PgBouncer는 애플리케이션의 Connection Pooling을 담당하고, HAProxy는 Patroni가 제공하는 PostgreSQL 노드의 Role 정보를 기준으로 Writer와 Reader를 구분하여 Routing 합니다. Keepalived는 PgBouncer Endpoint의 장애를 빠르게 감지할 수 있도록 VIP를 제어하는 역할을 담당합니다.
PgBouncer Alias를 이용한 Write / Read Endpoint 분리
이번 구성에서는 PgBouncer의 postgres_write, postgres_read Database Alias를 단순한 DB 별칭이 아니라 애플리케이션이 사용하는 논리적인 Write/Read Endpoint로 활용합니다.
애플리케이션에서는 실제 PostgreSQL 노드의 IP나 HAProxy의 Port를 직접 관리할 필요 없이, 쓰기 작업은 postgres_write, 읽기 작업은 postgres_read로 접속하면 됩니다. 이를 통해 애플리케이션의 접속 구성을 단순화하면서도 Write/Read 경로를 명확하게 분리할 수 있습니다.
PgBouncer와 HAProxy 간 Unix Domain Socket 통신
PgBouncer와 HAProxy는 동일한 서버에서 동작하므로 두 프로세스 간 연결에는 TCP/IP 대신 Unix Domain Socket을 사용하도록 구성하였습니다.
동일한 OS 내부에서 동작하는 프로세스 간 통신이기 때문에 별도의 IP Endpoint를 거치지 않고 Socket으로 직접 연결하여 통신 경로를 단순화하였습니다. 이를 통해 불필요한 TCP/IP 처리 오버헤드를 줄일 수 있으며, PgBouncer와 HAProxy 사이의 내부 연결을 네트워크 Port로 추가 노출하지 않아도 되는 장점도 있습니다.
즉 Client와 PgBouncer 사이에는 VIP/TCP를 사용하고, 동일 서버 내부의 PgBouncer와 HAProxy 사이는 Unix Domain Socket을 사용하는 형태로 외부 접속 경로와 내부 프로세스 통신 경로를 명확하게 분리한 구성입니다.
HAProxy의 PostgreSQL Role 기반 Routing
HAProxy 역시 단순한 Load Balancer 용도로 사용하지 않습니다. Patroni REST API를 통해 각 PostgreSQL 노드의 상태와 Role을 확인하고, Writer Endpoint에는 현재 Primary만, Reader Endpoint에는 Replica만 연결되도록 구성합니다.
따라서 Patroni에 의해 Failover가 발생하여 Primary 노드가 변경되더라도 PgBouncer나 애플리케이션의 접속 정보를 변경할 필요가 없습니다. HAProxy가 변경된 PostgreSQL Role을 확인하고 새로운 Primary 또는 Replica로 자동 Routing 합니다.
또한 사용 가능한 Replica가 없는 경우에는 Reader 요청을 Primary로 Fallback하도록 구성하여 Read Endpoint의 가용성도 함께 고려하였습니다.
Keepalived VIP를 이용한 Fast Connection Failure Detection
Keepalived의 VIP 사용 방식도 일반적인 Active/Standby 서비스 인계 구조와는 조금 다르게 구성하였습니다.
각 PgBouncer는 * 에 Bind하지 않고 자신에게 할당된 특정 VIP에만 Bind합니다. 장애가 발생하여 해당 VIP가 다른 노드로 이동하더라도, 이동된 VIP에서 다른 PgBouncer가 동일 서비스를 대신 제공하지는 않습니다.
이 VIP는 서비스 접속용도 보다는 Fast Connection Failure Detection을 위한 용도로 사용합니다. 장애가 발생한 PgBouncer Endpoint에 접속할 때 네트워크 TCP Timeout까지 기다리는 대신, 이동된 VIP에서 빠르게 Connection Failure를 반환하도록 하여 Client가 다음 PgBouncer Endpoint로 신속하게 전환할 수 있도록 구성한 것입니다.
Failover 된 VIP에 대해서 접속용도가 아닌 Fast Connection Failure Detection 을 위한 용도로 구성한 이유는 PgBouncer나 HAProxy가 정상화 되어서 VIP가 원래 서버로 이동하는 Failback 시 이미 생성된 Client Connection이 다시 끊기는 현상을 방지하기 위한 구성입니다.
만약 Failover 가 된 VIP가 접속에 사용하는 용도로 사용할 경우 해당 VIP로 접속이 이루어진 상태에서 VIP가 원래 서버로 복귀하는 Failback 이 되는 순간 해당 VIP를 통해 접속된 세션이 끊기는 상황이 발생하기 때문에 글의 아키텍쳐 디자인에서는 Failover 된 VIP는 접속 용도로 사용하지 않게 구성하였고 이러한 구성은 Oracle RAC의 VIP와 동일한 동작 방식을 가집니다.
정리하면 PgBouncer의 Database Alias를 Write/Read Endpoint로 활용하고, HAProxy에서 PostgreSQL Role 기반 Routing을 수행하며, Keepalived VIP를 서비스 인계가 아닌 빠른 접속 실패 감지 용도로 활용한 것이 이번 구성의 주요 설계 포인트입니다.
가용성 테스트
구성을 모두 적용한 뒤에는 PostgreSQL 역할 전환, 접속 계층 프로세스 장애, 접속 서버 장애, etcd 단일 노드 장애를 각각 분리하여 검증합니다. 한 테스트가 끝날 때마다 중지한 서비스 또는 서버를 복구하고, 다음 테스트를 시작하기 전에 사전 상태를 다시 확인합니다.
사전 상태 확인
PostgreSQL 서버 중 한 대에서 Patroni와 etcd의 상태를 확인하고, PgBouncer 서버 두 대에서는 VIP와 접속 계층 서비스 상태를 확인합니다.
# PostgreSQL 서버 중 한 대에서 실행
patronictl -c /etc/patroni/patroni.yml list

# PostgreSQL 서버 중 한 대에서 실행
etcdctl --endpoints=http://192.168.56.3:2379,http://192.168.56.4:2379,http://192.168.56.5:2379 endpoint health

# PgBouncer 서버 1, 2에서 각각 실행
sudo systemctl is-active pgbouncer haproxy keepalived
ip -br addr | grep -E '192\.168\.56\.(8|9)'
Patroni 출력에는 Leader 1대와 Replica 2대가 모두 running 상태로 표시되어야 합니다. etcd endpoint health는 세 노드가 healthy로 표시되어야 하며, PgBouncer 서버 두 대에서는 서비스가 active이고 VIP 192.168.56.8과 192.168.56.9가 각각 한 서버에만 할당되어 있어야 합니다.
글의 테스트 시스템의 상태는 pg_server1이 Leader(Primary, Writer) 인스턴스입니다.
장애 테스트 케이스
다음의 6개 케이스를 테스트합니다.
| 장애 상황 | 감지 주체 | 처리 방식 | 예상 중단 시간 |
| PostgreSQL Leader의 Patroni 프로세스 비정상 종료 | Patroni | 자동 Leader 선출 후 HAProxy가 헬스체크로 새 Leader를 감지하여 쓰기 대상 변경 | 3~30초 |
| PgBouncer 프로세스 중지 | keepalived | 해당 접속 서버가 보유하던 VIP를 반대쪽 정상 서버로 이동 | 수 초 |
| HAProxy 프로세스 중지 | keepalived | 해당 접속 서버가 보유하던 VIP를 반대쪽 정상 서버로 이동 | 수 초 |
| PgBouncer/HAProxy 서버 전체 중지 | keepalived VRRP master-down 타임아웃 | 중지된 서버가 보유하던 VIP를 반대쪽 정상 서버로 이동 | 약 3초 |
| etcd 노드 1대 중지 | etcd 클러스터 | 나머지 2대로 과반수를 유지하여 Patroni 클러스터 동작 지속 | 없음 |
| Replica 2대 모두 중지 | HAProxy | 새 postgres_read 조회를 Leader fallback으로 전달하고 조회 결과 IP가 Leader인지 확인 | 새 연결 기준 없음 |
케이스 1. PostgreSQL Leader 역할 전환
테스트에서는 postgres_write alias로 실제 INSERT를 수행하고, inet_server_addr()가 반환하는 PostgreSQL 서버 IP를 함께 기록합니다. 이 함수는 PgBouncer 또는 HAProxy가 아니라 INSERT를 처리한 PostgreSQL 백엔드 서버의 IP를 반환하므로, Leader 전환 전후 쓰기 대상이 바뀌었는지 확인할 수 있습니다.
클라이언트 또는 PgBouncer 서버에서 아래 명령으로 쓰기 alias에 접속합니다. 비밀번호를 입력한 뒤 psql 세션은 유지합니다.
psql "host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_write user=postgres connect_timeout=3"
psql 세션에서 테스트 테이블을 만들고, Leader 전환 전 INSERT를 수행합니다.
CREATE TABLE IF NOT EXISTS ha_write_failover_test (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    test_phase text NOT NULL,
    backend_ip inet NOT NULL,
    inserted_at timestamptz NOT NULL DEFAULT clock_timestamp()
);

INSERT INTO ha_write_failover_test (test_phase, backend_ip)
SELECT 'before_failover', inet_server_addr()
RETURNING id, test_phase, backend_ip, inserted_at;
이제 별도 터미널에서 현재 Leader를 확인한 뒤, 해당 PostgreSQL 서버에서 Patroni 서비스를 중지합니다.
# PostgreSQL 서버 중 한 대에서 현재 Leader 확인
patronictl -c /etc/patroni/patroni.yml list

# 현재 Leader 서버에서 patroni 중지를 실행(PostgreSQL 아님)
sudo systemctl stop patroni
먼저 서버측면에서 Failover 가 정상적으로 되었는지 남아 있는 다른 PostgreSQL 서버에서 다음과 같이 확인합니다.
# 남아 있는 PostgreSQL 서버 중 한 대에서 실행
patronictl -c /etc/patroni/patroni.yml list

# PgBouncer 서버에서 실행
echo "show stat" | sudo nc -U /var/lib/haproxy/stats | grep 'pg_write_back\|pg_read_back'
ip -br addr | grep -E '192\.168\.56\.(8|9)'
Patroni 출력에서 기존 Leader는 중지 상태가 되고, 기존 Replica 중 한 대가 Leader로 변경되어야 합니다. PgBouncer와 HAProxy 프로세스에 장애가 발생한 상황이 아니므로 VIP 192.168.56.8과 192.168.56.9의 할당 위치는 변경되지 않아야 합니다.
다음과 같이 입력 쿼리 수행 후 조회를 수행합니다.
INSERT INTO ha_write_failover_test (test_phase, backend_ip)
SELECT 'after_failover', inet_server_addr()
RETURNING id, test_phase, backend_ip, inserted_at;

SELECT id, test_phase, backend_ip, inserted_at
FROM ha_write_failover_test
ORDER BY id DESC
LIMIT 2;
after_failover 행의 backend_ip는 첫 번째 before_failover 행과 다른 PostgreSQL 서버 IP여야 합니다. 이 결과로 애플리케이션이 계속 사용하는 postgres_write alias와 VIP를 변경하지 않아도, HAProxy가 새 Leader로 쓰기 연결을 전달했음을 확인할 수 있습니다.
 id |   test_phase    |  backend_ip  |          inserted_at
----+-----------------+--------------+-------------------------------
 34 | after_failover  | 192.168.56.4 | 2026-xx-xx xx:xx:xx
  1 | before_failover | 192.168.56.3 | 2026-xx-xx xx:xx:xx
테스트가 끝나면 중지한 서버에서 Patroni 서비스를 시작하고, 해당 노드가 Replica로 다시 합류하는지 확인합니다.
sudo systemctl start patroni
patronictl -c /etc/patroni/patroni.yml list
케이스 2. PgBouncer 프로세스 장애와 VIP 이동
현재 서버의 상태이며 PgBouncer 1번 서버의 정보입니다. VIP인 192.168.56.8 이 할당되어있는 것을 확인할 수 있습니다. (IPv6 정보는 제외합니다)
ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.6/24 192.168.56.8/32
PgBouncer 서비스 종료 후 확인해보도록 하겠습니다.
# VIP를 보유한 PgBouncer 서버에서 실행
sudo systemctl stop pgbouncer

# 반대쪽 PgBouncer 서버에서 실행
sudo journalctl -u keepalived --since '2 minutes ago' --no-pager
ip -br addr | grep -E '192\.168\.56\.(8|9)'
IP를 조회하면 8번과 9번 VIP2개 모두가 할당된 것을 확인할 수 있습니다.
ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.7/24 192.168.56.9/32 192.168.56.8/32
테스트가 끝나면 중지한 서버에서 PgBouncer를 시작하고, keepalived 우선순위와 설정된 preempt 정책에 따라 원래 VIP가 반환되는지 확인합니다.
sudo systemctl start pgbouncer
sudo systemctl is-active pgbouncer

ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.6/24 192.168.56.8/32
케이스 3. HAProxy 프로세스 장애와 VIP 이동
PgBouncer와 HAProxy가 같은 서버에 구성되어 있으므로 HAProxy가 중지되면 해당 서버의 PgBouncer도 정상적인 PostgreSQL 연결을 제공할 수 없습니다. PgBouncer가 정상인 상태에서 HAProxy만 중지하여 keepalived 감시가 VIP를 이동시키는지 확인합니다.
# VIP를 보유한 PgBouncer 서버에서 실행
sudo systemctl stop haproxy

# 반대쪽 PgBouncer 서버에서 실행
sudo journalctl -u keepalived --since '2 minutes ago' --no-pager
ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.7/24 192.168.56.9/32 192.168.56.8/32
다른 서버에서 8번, 9번 VIP가 모두 정상적으로 할당되어 있는 것을 확인할 수 있습니다.
이 상태에서 time 명령어를 통해서 명령어 실행(실패 또는 접속 완료) 얼마나 소요되었는지를 확인하는 테스트를 진행하겠습니다.
VIP 접속 테스트
[상황1] failover 된 VIP인 8번을 통해서 접속 시도합니다.
8번 VIP는 failover 되어 다른 서버로 넘어온 상태로 해당 VIP로는 포트 바인딩이 되어 있지 않기 때문에 접속이 되지 않습니다. 다만 접속 불가 처리가 매우 빠르게 이루어집니다.
time env PGPASSWORD='postgres' psql "host=192.168.56.8 port=6432 dbname=postgres_write user=postgres connect_timeout=10" -c "SELECT 1;"

psql: error: connection to server at "192.168.56.8", port 6432 failed: Connection refused
    Is the server running on that host and accepting TCP/IP connections?

real 0m0.157s
user 0m0.010s
sys	 0m0.000s
[상황2] 존재하지 않는 임의의 IP로 접속 시도합니다.
존재 하지 않는 IP로 접속시 접속은 실패하였고 이번에는 시간이 10초가 소요되었습니다. 결론적으로 상황1도 상황2도 접속을 할 수 없는 상황은 동일하나 IP존재여부에 따라서 Timeout이 발생하는데 차이가 발생합니다. 여기서는 connect_timeout=10 옵션을 사용하였기 때문에 10초이지만 해당 옵션을 주지 않았을 경우 OS나 시스템, 네트워크의 timeout 만큼인 길게는 10분(600초) 가량 대기할 수도 있게 됩니다.
time env PGPASSWORD='postgres' psql "host=111.111.111.111 port=6432 dbname=postgres_write user=postgres connect_timeout=10" -c "SELECT 1;"
psql: error: connection to server at "111.111.111.111", port 6432 failed: timeout expired

real 0m10.026s <!--
user 0m0.001s
sys  0m0.010s
[상황3] Failover 된 VIP 와 해당 노드의 VIP 둘다 사용하는 경우
VIP를 둘다 기술하고 VIP1개는 Failover 된 상황에서 접속도 정상적으로 되며 접속에 소요되는 시간도 지연없이 빠르게 되는 것을 확인할 수 있습니다. (수차례 테스트에도 동일)
time env PGPASSWORD='postgres' psql "host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_write user=postgres connect_timeout=10" -c "SELECT 1;"
 ?column?
----------
        1
(1 row)


real 0m0.036s
user 0m0.009s
sys	 0m0.016s
VIP가 접속이 되지 않은 형태, 즉 포트 바인딩이 되어 있지 않더라도 존재하면 Fast Connection Failure Detection 에 의해 빠른 실패를 응답받고, IP가 존재 하지 않을경우 긴 Network Timeoout 동안 응답을 기다리게 됩니다.
글에서 의도한것과 같이 VIP가 Failover 되더라도 접속에는 특이사항이 없는 것을 확인할 수 있습니다. 물론 애플리케이션 접속 설정에서 반드시 모든 VIP가 설정되어있어야 합니다.
Failover 된 VIP를 접속에 사용하지 않고 Fast Connection Failure Detection 용도로 사용하는지는 이전의 "Architecture Design Overview" 내용에서 확인해보시면 됩니다.
테스트가 끝나면 중지한 서버에서 HAProxy와 PgBouncer 상태를 복구하고, VIP가 원래 위치로 반환되는지 확인합니다.
sudo systemctl start haproxy
sudo systemctl is-active haproxy

ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.6/24 192.168.56.8/32
케이스 4. PgBouncer/HAProxy 서버 전체 장애
이 테스트는 해당 접속 서버의 SSH 연결이 즉시 종료되므로 물리 서버의 경우 주의가 필요하며 VM이나 Cloud 서버의 경우도 테스트 완료 후 다시 시스템을 시작해야합니다.
다음과 같이 시스템을 종료하고 반대편 서버에서 확인하였을 경우 VIP가 정상적으로 Failover 및 쿼리 수행도 정상적으로 실행되는것을 확인할 수 있습니다.
# 테스트 대상 PgBouncer 서버에서 실행. SSH 연결이 종료됩니다.
sudo systemctl poweroff

# 반대쪽 PgBouncer 서버에서 실행
sudo journalctl -u keepalived --since '2 minutes ago' --no-pager
ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.7/24 192.168.56.9/32 192.168.56.8/32

# 쿼리 수행 테스트
time env PGPASSWORD='postgres' psql "host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_write user=postgres connect_timeout=10" -c "SELECT 1;"
 ?column?
----------
        1
(1 row)

real 0m0.011s
user 0m0.000s
sys	 0m0.007s
서버를 다시 시작한 뒤 PgBouncer, HAProxy, keepalived가 모두 active인지 확인하고, 설정된 preempt 정책에 따라 VIP가 원래 위치로 반환되는지 확인합니다.
sudo systemctl is-active pgbouncer haproxy keepalived
active
active
active

ip -br addr | grep -E '192\.168\.56\.(8|9)'
enp0s9           UP             192.168.56.6/24 192.168.56.8/32
케이스 5. etcd 노드 1대 장애
PostgreSQL 서버 한 대에서 etcd만 중지합니다. 동시에 두 대 이상을 중지하면 과반수를 잃으므로 이 테스트에서는 한 대만 중지합니다.
중지한 etcd endpoint는 unhealthy 또는 연결 실패로 확인되고 나머지 두 endpoint는 healthy 상태로 확인되며 patroni 를 통한 클러스터 상태도 정상인 것을 확인할 수 있습니다.
# PostgreSQL 서버 한 대에서 실행
sudo systemctl stop etcd

# 다른 PostgreSQL 서버에서 실행
etcdctl --endpoints=http://192.168.56.3:2379 endpoint health
http://192.168.56.3:2379 is healthy: successfully committed proposal: took = 5.239489ms

etcdctl --endpoints=http://192.168.56.4:2379 endpoint health
http://192.168.56.4:2379 is healthy: successfully committed proposal: took = 3.032892ms

etcdctl --endpoints=http://192.168.56.5:2379 endpoint health
<== 에러 발생

patronictl -c /etc/patroni/patroni.yml list
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Leader  | running   | 13 |             |     |            |     |
| pg_server2 | 192.168.56.4 | Replica | streaming | 13 |   0/B003860 |   0 |  0/B003860 |   0 |
| pg_server3 | 192.168.56.5 | Replica | streaming | 13 |   0/B003860 |   0 |  0/B003860 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
중지한 etcd endpoint는 unhealthy 또는 연결 실패로 표시되지만, 나머지 두 endpoint는 healthy여야 합니다. Patroni 출력에는 Leader 1대와 Replica 2대가 계속 표시되어야 하며, PostgreSQL 역할 전환이나 VIP 이동이 발생하지 않아야 합니다.
테스트가 끝나면 중지한 서버에서 etcd를 시작하고, 세 endpoint가 모두 healthy 상태로 복구되는지 확인합니다.
sudo systemctl start etcd
etcdctl --endpoints=http://192.168.56.3:2379,http://192.168.56.4:2379,http://192.168.56.5:2379 endpoint health
케이스 6. Replica 0대일 때 postgres_read의 Leader fallback
현재 Leader는 유지하고, Patroni 출력에서 Replica로 표시된 PostgreSQL 서버 두 대의 Patroni 서비스만 중지합니다. Leader를 중지하면 쓰기 failover 테스트가 되므로 이 테스트에서는 중지하지 않습니다.
# PostgreSQL 서버 중 한 대에서 현재 Leader와 Replica 확인
patronictl -c /etc/patroni/patroni.yml list
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Leader  | running   | 13 |             |     |            |     |
| pg_server2 | 192.168.56.4 | Replica | streaming | 13 |   0/B003860 |   0 |  0/B003860 |   0 |
| pg_server3 | 192.168.56.5 | Replica | streaming | 13 |   0/B003860 |   0 |  0/B003860 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
먼저 Replica 서버에 접속하여 쿼리를 수행하여 현재 읽기 요청이 어느 서버로 전달되는지 확인합니다.
env PGPASSWORD='postgres' psql \
"host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_read user=postgres connect_timeout=10 load_balance_hosts=random" \
-c "SELECT inet_server_addr() AS server_ip, inet_server_port() AS server_port, pg_is_in_recovery() AS is_replica;"

  server_ip   | server_port | is_replica
--------------+-------------+------------
 192.168.56.5 |        5432 | t
위의 조회 결과가 나온 Replica 서버부터 다음과 같이 종료합니다.
# Replica인 PostgreSQL 서버에서 실행
sudo systemctl stop patroni
그 다음 다시 쿼리를 수행해서 읽기 쿼리가 정상적으로 수행되는지 확인합니다.
env PGPASSWORD='postgres' psql \
"host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_read user=postgres connect_timeout=10 load_balance_hosts=random" \
-c "SELECT inet_server_addr() AS server_ip, inet_server_port() AS server_port, pg_is_in_recovery() AS is_replica;"

  server_ip   | server_port | is_replica
--------------+-------------+------------
 192.168.56.4 |        5432 | t
이제 다시 남은 Replica 서버에서 종료를 수행합니다.
# Replica인 PostgreSQL 서버에서 실행
sudo systemctl stop patroni
그 다음 다시 조회를 수행하면 다음과 같이 Leader(Writer) 인 3번 서버에서 수행되는 것을 확인할 수 있고 is_replica = f 정보를 통해서 Replica 인스턴스가 아닌 Writer 인 것을 확인할 수 있습니다.
env PGPASSWORD='postgres' psql \
"host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_read user=postgres connect_timeout=10 load_balance_hosts=random" \
-c "SELECT inet_server_addr() AS server_ip, inet_server_port() AS server_port, pg_is_in_recovery() AS is_replica;"

  server_ip   | server_port | is_replica
--------------+-------------+------------
 192.168.56.3 |        5432 | f
테스트가 끝나면 중지한 Replica 서버 두 대에서 Patroni를 시작하고, 서버의 상태를 확인하여 정상적으로 시작 및 복제가 되고 있는지를 확인합니다.
# 중지했던 Replica 서버 두 대에서 각각 실행
sudo systemctl start patroni

# Patroni 멤버 상태 확인
patronictl -c /etc/patroni/patroni.yml list
Replica 인스턴스가 정상으로 복구 후 쿼리를 수행해보면 Replica 인스턴스에서 수행되는 것을 확인할 수 있습니다.
env PGPASSWORD='postgres' psql \
"host=192.168.56.8,192.168.56.9 port=6432 dbname=postgres_read user=postgres connect_timeout=10 load_balance_hosts=random" \
-c "SELECT inet_server_addr() AS server_ip, inet_server_port() AS server_port, pg_is_in_recovery() AS is_replica;"

  server_ip   | server_port | is_replica
--------------+-------------+------------
 192.168.56.4 |        5432 | t
Conclusion
이번 구성에서는 Patroni와 etcd로 PostgreSQL 3대 클러스터를 관리하고, PgBouncer·HAProxy·keepalived를 통해 애플리케이션의 접속 지점과 PostgreSQL 역할 전환을 분리했습니다. 애플리케이션은 두 개의 VIP와 postgres_write, postgres_read alias만 사용하며, 실제 Leader와 Replica의 변경은 Patroni 상태와 HAProxy 헬스체크 결과에 따라 처리됩니다.
테스트를 통해 PostgreSQL Leader 전환, PgBouncer 또는 HAProxy 프로세스 장애, 접속 서버 전체 장애, etcd 노드 1대 장애를 확인했습니다. Reader Replica 두 대가 모두 중지된 경우에도 새 postgres_read 연결은 현재 Leader로 전달되며, Replica가 복구된 뒤 새 연결은 다시 Reader backend로 전달되는 것을 검증했습니다.
HAProxy Reader 소켓에 직접 새 연결을 생성한 결과도 두 Replica에 라운드로빈으로 분산되었고, 각 조회가 Replica에서 처리되는 것을 확인했습니다.
장애 대응에서 중요한 점은 keepalived와 HAProxy의 역할이 다르다는 것입니다.
keepalived는 PgBouncer와 HAProxy가 동작하는 접속 서버의 가용성을 감시해 VIP를 이동시키고, HAProxy는 PostgreSQL의 Leader와 Replica 상태를 확인해 연결 대상을 선택합니다.
두 계층을 분리하면 PostgreSQL 역할 전환이 발생해도 접속 VIP를 불필요하게 이동시키지 않으며, 접속 서버 장애와 데이터베이스 역할 전환을 각각의 상태에 맞게 처리할 수 있습니다.
이번들에서는 애플리케이션 측면에서 설정된 접속 정보 변경 없이 유연하고 최대한 간편하게 사용하기 위한 방향과 여러 각각의 구성요소의 장애 발생시에도 데이터베이스를 사용할 수 있도록 지속석을 고려하여 작성된 아키텍쳐를 소개해드렸습니다.
다음 글에서는 이렇게 구성된 상태에서의 업그레이드 및 기타 상황에 대해서 확인해보도록 하겠습니다.
긴 글 읽어주셔서 감사합니다.
Reference
- PostgreSQL 17 Streaming Replication 공식 문서
- Patroni 공식 문서
- PgBouncer 공식 문 서
- HAProxy 공식 문서
- Keepalived 공식 문서
Principal DBA(MySQL, AWS Aurora, Oracle)
핀테크 서비스인 핀다에서 데이터베이스를 운영하고 있어요(at finda.co.kr)
Previous - 당근마켓, 위메프, Oracle Korea ACS / Fedora Kor UserGroup 운영중
Database 외에도 NoSQL , Linux , Python, Cloud, Http/PHP CGI 등에도 관심이 있습니다
purityboy83@gmail.com / admin@hoing.io