Last Updated on 11월 2, 2026 by Jade(정현호)
안녕하세요
이번글은 PostgreSQL에서 Patroni를 사용한 고가용성 시스템 구성에 대해서 확인해보도록 하겠습니다.
Patroni와 etcd를 통한 PostgreSQL 고가용성 개요
PostgreSQL 자체에는 장애가 났을 때 Standby를 Primary로 자동 승격시키는 기능이 없습니다. Streaming Replication으로 Primary와 Standby를 구성하는 것까지는 PostgreSQL이 직접 처리하지만, Primary가 비정상 종료 되었을 때 어느 Standby를 새 Primary로 올릴지 판단하고 실행하는 역할은 별도의 소프트웨어가 맡아야 합니다.
DBMS 마다 자체적으로 기능 또는 Component가 포함되어있을수도 있지만 PostgreSQL 처럼 기본적으로 포함되어 있지 않을수도 있습니다. 이럴 때는 별도의 상용 또는 오픈소스의 HA(High Availability)를 통해서 고가용성을 구성합니다.
PostgreSQL에서도 사용 가능한 여러 HA 고가용성 솔루션이 존재하며 그중 하나가 Patroni 입니다.
Patroni는 PostgreSQL 인스턴스 하나당 한 개씩, 같은 서버에서 함께 실행되는 에이전트로 PostgreSQL 프로세스를 직접 기동·정지시키고, postgresql.conf와 pg_hba.conf를 관리하며, Replication 설정과 장애 발생 시의 승격까지 전부 Patroni가 수행합니다. 이 구성에서 PostgreSQL을 systemd로 직접 관리하지 않는 이유도, PostgreSQL의 생명주기 전체를 Patroni가 전담하기 때문입니다.
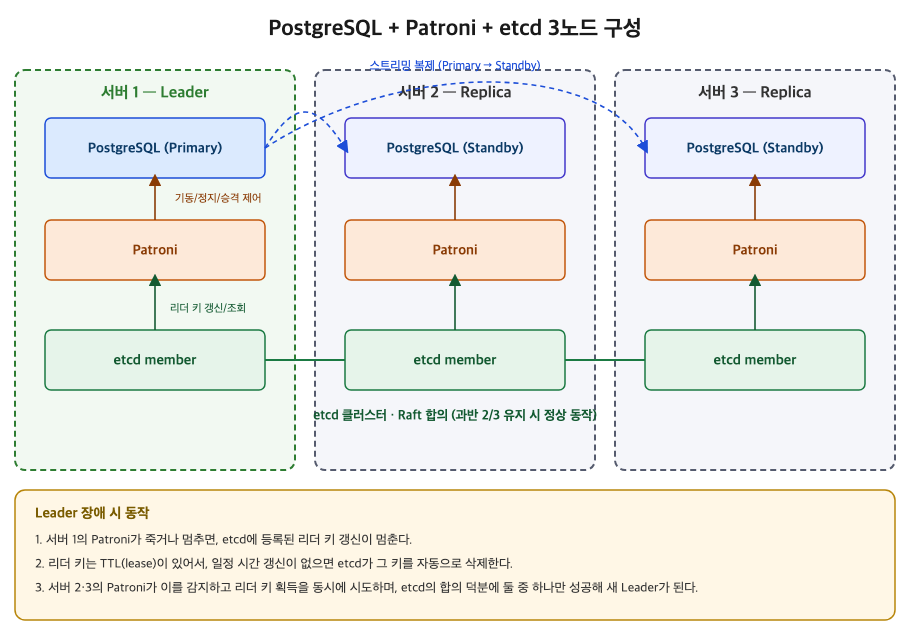
문제는 Patroni가 서버마다 따로 구동되어 있고 서로 직접 통신하지 않는다는 점입니다. 지금 누가 Primary인지를 여러 노드가 합의해야 하는데, Patroni는 이 합의를 위해 외부의 공유 저장소를 씁니다. 이 저장소를 DCS(Distributed Configuration Store)라고 부르며, 이번 글에서는 etcd를 사용합니다.
etcd는 Raft 합의 알고리즘을 구현한 분산 Key-Value 저장소입니다. 여러 노드로 구성되어도 전체 노드 중 과반수가 합의해야만 값을 쓰거나 바꿀 수 있고, 한 번 합의된 값은 모든 노드에서 동일하게 보장됩니다. 네트워크가 일시적으로 끊기거나 일부 노드가 죽어도, 남은 노드가 과반수를 유지하는 한 etcd는 정상 동작합니다. 3노드 구성에서는 1대가 죽어도 나머지 2대로 과반수(2/3)를 유지할 수 있습니다.
Patroni는 이 etcd에 leader 키 하나를 둡니다. 현재 Primary 역할을 하는 노드의 Patroni가 이 키를 짧은 주기로 계속 갱신하면서 자신이 Leader임을 유지합니다. 이 키에는 TTL이 걸려 있어서, Leader의 Patroni가 죽거나 응답하지 않아 일정 시간 갱신이 안 되면 etcd가 그 키를 자동으로 삭제합니다.
나머지 Standby들의 Patroni는 이 키를 지켜보고 있다가 키가 사라지면 동시에 새로 획득을 시도합니다. etcd의 합의 덕분에 이 중 정확히 하나만 키를 가져갈 수 있고, 그 노드의 Patroni가 자신의 PostgreSQL을 Primary로 승격시킵니다. 나머지는 새 Primary를 바라보도록 Replication 설정을 바꿉니다.
역할을 정리하면, etcd는 PostgreSQL에 대해 아무것도 모르는, 순수하게 누가 leader 키를 쥐고 있는지만 합의해주는 저장소입니다. Patroni는 PostgreSQL을 실제로 다루는 역할을 하고, etcd가 가진 합의 결과를 보고 승격과 장애조치를 실행합니다. 두 구성 요소가 합쳐져야 PostgreSQL의 자동 Failover가 완성됩니다.
환경 정보 및 네트워크 구성 정보
환경 정보
글에서 사용한 테스트 환경에 대한 요약입니다.
| 항목 | 내용 |
| OS | Rocky Linux 9, aarch64(ARM) |
| PostgreSQL 버전 | 17 (PGDG 패키지 설치) |
| PostgreSQL 바이너리 위치 | /usr/pgsql-17/bin |
| 데이터 경로 - PostgreSQL - Patroni - etcd |
/data/pgdata/17, /data/pglog /data/patroni /data/etcd |
| Patroni 설정 경로 | /etc/patroni/patroni.yml |
| PgBouncer/HAProxy/keepalived 로그 경로 | /var/log/pgbouncer/ /var/log/haproxy /var/log/keepalived |
| 서버구성 | 서버 레이어: PostgreSQL+Patroni+etcd 3대 클라이언트 레이어: PgBouncer+HAProxy+keepalived 2대 총 5대 구성 |
서버 구성 및 네트워크 정보
글의 테스트 시스템의 서버 구성 및 시스템 별 IP 정보입니다. PostgreSQL 노드 사이의 Patroni, etcd, Streaming Replication 통신과 PgBouncer·HAProxy·keepalived 통신에 이 주소를 사용합니다.
| 서버 또는 VIP | IP주소 | 역할 |
| pg_server1 | 192.168.56.3 | PostgreSQL 초기 Leader + Patroni + etcd |
| pg_server2 | 192.168.56.4 | PostgreSQL Replica + Patroni + etcd |
| pg_server3 | 192.168.56.5 | PostgreSQL Replica + Patroni + etcd |
| pgbouncer_server1 | 192.168.56.6 | PgBouncer + HAProxy + keepalived |
| pgbouncer_server2 | 192.168.56.7 | PgBouncer + HAProxy + keepalived |
| vip1 | 192.168.56.8 | keepalived가 관리하고 pgbouncer_server1에 고정된 PgBouncer 가 직접 bind 합니다. |
| vip2 | 192.168.56.9 | keepalived가 관리하고 pgbouncer_server2에 고정된 PgBouncer가 직접 bind 합니다. |
PgBouncer 와 HAProxy, Keepalived에 대한 자세한
방화벽 / 보안 그룹 체크리스트
글에서 사용하는 Rocky Linux 9는 firewalld가 기본으로 켜져 있으므로, 다음 표의 포트를 실제로 열어야 서비스가 정상 동작합니다.
| 출발 | 도착 | 포트 | 용도 |
| pg_server 상호간 | pg_server 전체 | 5432 | 복제 |
| pg_server 상호간 | pg_server 전체 | 2379, 2380 | etcd |
| pgbouncer_server 전체 | pg_server 전체 | 5432, 8008 | HAProxy → PostgreSQL / Patroni REST 헬스체크 |
| Application | pgbouncer_server 전체 | 6432 | PgBouncer |
| pgbouncer_server 상호간 | pgbouncer_server 전체 | VRRP(IP 프로토콜 112번) | keepalived |
pg_server1, pg_server2, pg_server3 3대 모두에서 각각 실행합니다. (PostgreSQL, Patroni REST, etcd)
sudo firewall-cmd --permanent --add-port=5432/tcp
sudo firewall-cmd --permanent --add-port=8008/tcp
sudo firewall-cmd --permanent --add-port=2379/tcp
sudo firewall-cmd --permanent --add-port=2380/tcp
sudo firewall-cmd --reload

# 정책 목록 확인
sudo firewall-cmd --list-all
pgbouncer_server1, pgbouncer_server2 2대 모두에서 각각 실행합니다 (PgBouncer, keepalived, HAProxy)
PgBouncer는 VIP를 직접 bind해서 클라이언트 접속을 받고, postgres_write/postgres_read는 같은 서버 안의 HAProxy에 유닉스 소켓으로만 연결됩니다. 이 경로는 반대편 서버로 넘어갈 수 없으므로, VIP가 이동해도 PgBouncer가 반대편 서버의 HAProxy에 접속하는 경우는 없습니다. 그래서 pgbouncer_server 상호간에는 keepalived가 쓰는 VRRP만 열면 됩니다.
sudo firewall-cmd --permanent --add-port=6432/tcp
sudo firewall-cmd --permanent --add-protocol=vrrp
sudo firewall-cmd --reload

# 정책 목록 확인
sudo firewall-cmd --list-all
OS나 베이스 이미지 셋팅에 따라서 다르겠지만 Rocky Linux 기본은 SeLinux가 활성화 되어 있으며 해당 글에서는 SeLinux 를 비활성화 하겠습니다.
# config 파일 수정
sudo vi /etc/selinux/config

# 다음과 같이 수정
SELINUX=disabled

# 파일을 수정하였다면 다음과 같이 비활성화
setenforce 0
PostgreSQL + Patroni + etcd 구성
OS 패키지 설치(5대 공통)
이번 글에서 구성되는 5대 서버 모두에서 다음과 같이 저장소 등록 및 패키지를 설치하도록 하겠습니다.
# EPEL 저장소 활성화
sudo dnf install -y epel-release
sudo dnf config-manager --set-enabled crb

# 패키지 설치
sudo dnf install -y net-tools openssl openssl-devel libaio libaio-devel nmap-ncat socat \
bison make cmake readline gcc gcc-c++ numactl numactl-devel glibc coreutils net-tools \
tar gzip git tcl wget screen expect jq cronie python3 python3-pip python3-libs xz-libs
PostgreSQL 설치(3대 공통)
PGDG 저장소 등록
PostgreSQL를 설치하기 위해서 PGDG 저장소를 설치 합니다. PGDG 저장소는 PostgreSQL Global Development Group이 제공하는 공식 패키지 저장소입니다. OS 기본 저장소보다 최신 PostgreSQL 메이저·마이너 버전과 관련 도구를 설치할 수 있도록 제공합니다.
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-aarch64/pgdg-redhat-repo-latest.noarch.rpm
sudo dnf -qy module disable postgresql
설치
sudo dnf install -y postgresql17-server postgresql17-contrib
데이터 볼륨 준비
글에서는 "/data" 경로 아래에 다음과 같이 구성하도록 하겠습니다.
sudo mkdir -p /data/{pgdata/17,pglog,etcd,patroni}
sudo chown postgres:postgres /data/pgdata/17 /data/pglog /data/patroni
/data/etcd는 이 시점에 chown하지 않습니다 — etcd 설치 섹션에서 서비스 등록 직전에 별도로 chown합니다.
/data/patroni는 Patroni 로그 디렉터리(patroni.yml의 log.dir)로 쓰이므로 여기서 미리 postgres 소유로 바꿔둡니다. 이걸 빠뜨리면 Patroni가 User=postgres로 기동할 때 /data/patroni/patroni.log 쓰기 권한이 없어 PermissionError로 즉시 종료됩니다.
PGDATA 경로 지정(3대 공통)
다음은 systemd drop-in 설정과 daemon-reload는 3대 모두에서 실행합니다.
systemd는 /etc/systemd/system/<유닛이름>.service.d/ 디렉터리 아래의 .conf 파일들을 원래 유닛 파일 위에 자동으로 오버라이드합니다. mkdir -p로 이 디렉터리를 만들고, tee와 heredoc으로 그 안에 override.conf 파일을 바로 써넣습니다.
tee 뒤의 > /dev/null은 내용이 화면에 그대로 출력되는 걸 막는 것이고, <<'EOF_SERVICE' … EOF_SERVICE는 그 사이 텍스트를 tee의 표준입력으로 전달하는 heredoc입니다.
sudo mkdir -p /etc/systemd/system/postgresql-17.service.d
sudo tee /etc/systemd/system/postgresql-17.service.d/override.conf > /dev/null <<'EOF_SERVICE'
[Service]
Environment=PGDATA=/data/pgdata/17
EOF_SERVICE

sudo systemctl daemon-reload
sudo systemctl show postgresql-17.service -p Environment
마지막 명령 결과에 Environment=PGDATA=/data/pgdata/17이 보이면 정상 반영된 것입니다.
초기 Leader 초기화 및 PostgreSQL 설정
pg_server1 클러스터 초기화 (initdb)
pg_server2와 pg_server3은 initdb를 하지 않고 pg_basebackup을 통해 초기 구성을 수행하며, 그러므로 Standby의 데이터 디렉터리는 비워 둡니다.
ls -al /usr/pgsql-17/bin

PG_BIN=/usr/pgsql-17/bin

sudo -u postgres "$PG_BIN/initdb" \
    -D /data/pgdata/17 \
    --username=postgres \
    --encoding=UTF8 \
    --locale=C \
    --auth-local=peer \
    --auth-host=scram-sha-256 \
    --data-checksums \
    --pwprompt
글에서 사용한 초기화 옵션은 다음과 같습니다.
- --data-checksums: 데이터 페이지 손상을 탐지할 수 있도록 체크섬을 활성화합니다. PostgreSQL 17에서는 기본으로 활성화되지 않으므로 명시했습니다.
- --auth-host=scram-sha-256: 호스트 연결 인증 방식을 SCRAM-SHA-256으로 지정합니다. 아래에서 설정하는 pg_hba.conf의 인증 방식과 일치시킵니다.
- --pwprompt: postgres 슈퍼유저의 비밀번호를 대화형으로 입력받습니다. 확인을 위해 같은 비밀번호를 두 번 입력합니다.
- --locale=C: 초기 Leader 클러스터의 로케일을 C로 지정합니다. Standby는 pg_basebackup으로 Primary 클러스터를 복사하므로 같은 로케일을 이어받습니다. 다른 로케일을 선택하려면 Primary를 초기화할 때 지정합니다.
postgresql.conf / pg_hba.conf 설정
파일 위치는 /data/pgdata/17/postgresql.conf 이며 다음과 같이 수정합니다.
listen_addresses = '*'              # 원격 서버 접속을 받아야 하므로 localhost 불가
wal_level = logical
log_directory = '/data/pglog'
이번에는 /data/pgdata/17/pg_hba.conf 파일의 수정입니다. pg_hba.conf는 PostgreSQL의 Host-Based Authentication 설정 파일입니다. 클라이언트 IP, 대상 데이터베이스와 사용자, 인증 방식을 기준으로 접속 허용 여부를 제어합니다.
# 노드 간 복제 허용 (pg_server1~3 상호간)
host  replication  replicator  192.168.56.3/32  scram-sha-256
host  replication  replicator  192.168.56.4/32  scram-sha-256
host  replication  replicator  192.168.56.5/32  scram-sha-256

# PgBouncer 서버(HAProxy 경유)에서의 접속 허용
host  all           all         192.168.56.6/32   scram-sha-256
host  all           all         192.168.56.7/32   scram-sha-256

# Patroni가 로컬 PostgreSQL에 헬스체크/관리 연결 시 사용 (각 노드 자기 자신의 IP)
host  all  postgres  192.168.56.3/32  scram-sha-256
host  all  postgres  192.168.56.4/32  scram-sha-256
host  all  postgres  192.168.56.5/32  scram-sha-256
postgresql.conf와 pg_hba.conf를 먼저 수정한 뒤, pg_server1에서만 서비스를 시작합니다.
sudo systemctl start postgresql-17
이 단계에서 자동 시작을 설정할 필요는 없습니다. 이후 Patroni가 PostgreSQL 프로세스 관리를 맡으면 PostgreSQL 서비스를 비활성화합니다.
Standby 복제 구성
복제 계정 생성 (초기 Leader: pg_server1)
고가용성 구성은 기본적으로 PostgreSQL간 복제를 기반으로 하기 때문에 먼저 복제 구성을 위해서 전용 복제 계정을 생성 및 REPLICATION 속성을 지정합니다.
$ sudo -u postgres psql

CREATE ROLE replicator WITH REPLICATION LOGIN PASSWORD 'Replicator@2026';
비밀번호의 예시입니다.
Standby 생성 및 시작 (pg_basebackup)
pg_server2와 pg_server3에서는 initdb나 PostgreSQL 서비스 시작을 하지 않은 상태로 진행합니다. pg_basebackup의 대상 디렉터리는 비어 있어야 하므로, /data/pgdata/17에 기존 파일이 없는지 확인한 뒤 각 Standby에서 실행합니다.
pg_basebackup은 Primary의 데이터와 설정을 복사하고, -R 옵션으로 Standby 설정을 기록합니다.
복제 슬롯을 반드시 같이 만듭니다. 슬롯 없이 받으면 Primary는 이 Standby가 어디까지 WAL을 받아갔는지 모르기 때문에, 베이스백업이 끝난 뒤 Standby가 실제로 스트리밍을 시작하기 전에 Primary가 필요한 WAL을 체크포인트로 지워버릴 수 있습니다(이 경우 "requested WAL segment … has already been removed" 에러로 복제가 영구히 멈추고, 베이스백업을 처음부터 다시 받아야 합니다).
-C --slot 옵션으로 베이스백업과 동시에 슬롯을 만들면 이 문제가 원천 차단됩니다. pg_server2와 pg_server3은 슬롯 이름이 서로 달라야 하므로 각각 아래 명령을 그 노드에서 실행합니다.
pg_server2
sudo -u postgres /usr/pgsql-17/bin/pg_basebackup \
  -h 192.168.56.3 -p 5432 -U replicator \
  -D /data/pgdata/17 \
  -P -Xs -R \
  -C --slot=rs_node2_physical
pg_server3
sudo -u postgres /usr/pgsql-17/bin/pg_basebackup \
  -h 192.168.56.3 -p 5432 -U replicator \
  -D /data/pgdata/17 \
  -P -Xs -R \
  -C --slot=rs_node3_physical
pg_basebackup 실행이 완료된 뒤 pg_server2와 pg_server3에서 각각 PostgreSQL 서비스를 시작합니다.
sudo systemctl start postgresql-17
enable 없이 start만 하는 이유는 다음과 같습니다. 이후 Patroni가 postgres 시작/중지를 전담하므로, enable된 채로 재부팅하면 systemd와 Patroni가 동시에 PostgreSQL을 띄우려다 충돌합니다. 그래서 지금은 enable하지 않고, 나중에 Patroni 전환 단계에서 postgresql-17.service를 아예 disable합니다.
복제 상태 확인
Leader(pg_server1)
# # WAL 전송 상태 확인
sudo -u postgres psql -c "SELECT pid, application_name, client_addr, state, sync_state FROM pg_stat_replication;"

# slot 확인
sudo -u postgres psql -c "SELECT slot_name, slot_type, active, active_pid, restart_lsn FROM pg_replication_slots;"
Standby(pg_server2, pg_server3)
sudo -u postgres psql -c "SELECT now(), pg_is_in_recovery(), pg_last_wal_receive_lsn(), pg_last_wal_replay_lsn();"
etcd 설치 및 클러스터 구성
etcd 설치 (3대 공통, ARM 바이너리)
dnf(EPEL 9)에는 etcd 패키지 자체가 없어 아키텍처와 무관하게 GitHub 릴리즈 바이너리로 설치합니다. 이 서버는 ARM 아키텍처이므로 그중 linux-arm64 빌드를 받아야 합니다.
ETCD_VER=v3.7.2
curl -L https://github.com/etcd-io/etcd/releases/download/${ETCD_VER}/etcd-${ETCD_VER}-linux-arm64.tar.gz -o /tmp/etcd.tar.gz
tar xzf /tmp/etcd.tar.gz -C /tmp/
sudo cp /tmp/etcd-${ETCD_VER}-linux-arm64/etcd /usr/local/bin/
sudo cp /tmp/etcd-${ETCD_VER}-linux-arm64/etcdctl /usr/local/bin/
etcd --version
etcd 3노드 클러스터 기동
각 서버가 자기 자신의 실제 IP로 client/peer URL을 구성합니다. 포트는 3대 모두 동일(client 2379, peer 2380)합니다.
etcd는 PostgreSQL 설치 시 이미 만들어진 postgres OS 계정으로 실행합니다. 별도의 etcd 전용 OS 계정은 만들지 않습니다. 백그라운드 & 방식이 아니라 systemd 서비스로 등록해서 systemctl로 제어합니다. 그래야 비정상 종료 시 자동 재시작되고, 서버 재부팅 시에도 자동 기동됩니다.
etcd는 기동이 끝나면 sd_notify로 systemd에 신호를 보내므로, 유닛 파일에 Type=notify를 지정하면 systemd가 "etcd가 완전히 기동됐다"는 시점을 정확히 알 수 있습니다. --initial-cluster-state new는 /data/etcd가 비어 있는 최초 기동에만 적용되고, 이후 재시작 시에는 기존 데이터 디렉터리의 멤버 정보를 그대로 쓰므로 유닛 파일에 고정해둬도 안전합니다.
유닛 파일 내용은 pg_server1/2/3이 --name, --advertise-client-urls, --initial-advertise-peer-urls만 다르고 나머지는 동일합니다. 과반수 합의가 필요하므로 세 서버 모두 기동해야 클러스터가 구성됩니다.
pg_server1의 etcd
sudo mkdir -p /data/etcd
sudo chown postgres:postgres /data/etcd

sudo tee /etc/systemd/system/etcd.service > /dev/null <<'EOF_SERVICE'
[Unit]
Description=etcd distributed key-value store
After=network.target

[Service]
Type=notify
User=postgres
Group=postgres
ExecStart=/usr/local/bin/etcd \
  --name pg_server1 \
  --data-dir /data/etcd \
  --listen-client-urls http://0.0.0.0:2379 \
  --advertise-client-urls http://192.168.56.3:2379 \
  --listen-peer-urls http://0.0.0.0:2380 \
  --initial-advertise-peer-urls http://192.168.56.3:2380 \
  --initial-cluster "pg_server1=http://192.168.56.3:2380,pg_server2=http://192.168.56.4:2380,pg_server3=http://192.168.56.5:2380" \
  --initial-cluster-state new
Restart=on-failure
RestartSec=5
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
EOF_SERVICE

sudo systemctl daemon-reload
sudo systemctl enable --now etcd
pg_server2의 etcd
sudo mkdir -p /data/etcd
sudo chown postgres:postgres /data/etcd

sudo tee /etc/systemd/system/etcd.service > /dev/null <<'EOF_SERVICE'
[Unit]
Description=etcd distributed key-value store
After=network.target

[Service]
Type=notify
User=postgres
Group=postgres
ExecStart=/usr/local/bin/etcd \
  --name pg_server2 \
  --data-dir /data/etcd \
  --listen-client-urls http://0.0.0.0:2379 \
  --advertise-client-urls http://192.168.56.4:2379 \
  --listen-peer-urls http://0.0.0.0:2380 \
  --initial-advertise-peer-urls http://192.168.56.4:2380 \
  --initial-cluster "pg_server1=http://192.168.56.3:2380,pg_server2=http://192.168.56.4:2380,pg_server3=http://192.168.56.5:2380" \
  --initial-cluster-state new
Restart=on-failure
RestartSec=5
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
EOF_SERVICE

sudo systemctl daemon-reload
sudo systemctl enable --now etcd
sudo systemctl status etcd
pg_server3
sudo mkdir -p /data/etcd
sudo chown postgres:postgres /data/etcd

sudo tee /etc/systemd/system/etcd.service > /dev/null <<'EOF_SERVICE'
[Unit]
Description=etcd distributed key-value store
After=network.target

[Service]
Type=notify
User=postgres
Group=postgres
ExecStart=/usr/local/bin/etcd \
  --name pg_server3 \
  --data-dir /data/etcd \
  --listen-client-urls http://0.0.0.0:2379 \
  --advertise-client-urls http://192.168.56.5:2379 \
  --listen-peer-urls http://0.0.0.0:2380 \
  --initial-advertise-peer-urls http://192.168.56.5:2380 \
  --initial-cluster "pg_server1=http://192.168.56.3:2380,pg_server2=http://192.168.56.4:2380,pg_server3=http://192.168.56.5:2380" \
  --initial-cluster-state new
Restart=on-failure
RestartSec=5
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
EOF_SERVICE

sudo systemctl daemon-reload
sudo systemctl enable --now etcd
sudo systemctl status etcd
설정을 하였다면 각 서버에서 다음과 같이 상태를 확인합니다.
sudo systemctl status etcd --no-pager
sudo journalctl -u etcd -n 50 --no-pager
etcd 클러스터 상태를 다음과 같이 확인합니다.
etcdctl --endpoints=http://192.168.56.3:2379,http://192.168.56.4:2379,http://192.168.56.5:2379 endpoint health

etcdctl --endpoints=http://192.168.56.3:2379 endpoint status --write-out=table
etcdctl --endpoints=http://192.168.56.4:2379 endpoint status --write-out=table
etcdctl --endpoints=http://192.168.56.5:2379 endpoint status --write-out=table
Patroni 설치 및 설정
Patroni 설치 (3대 공통)
Patroni는 Python으로 작성된 PostgreSQL 고가용성(High Availability, HA) 구축 및 자동 장애 조치(Automatic Failover)를 위한 오픈소스 템플릿(솔루션)입니다. 다음과 같이 설치를 진행하겠습니다.
sudo dnf install -y python3-pip
pip3 install --upgrade pip setuptools
pip3 install patroni[etcd3]
pip3 install psycopg2-binary
Patroni 설정 파일 작성
patroni 설정을 하며 파일 위치 /etc/patroni/patroni.yml 입니다.
yml 파일 설정은 아래와 같으며 노드마다 name, restapi, postgresql의 IP만 다르고 etcd3의 hosts는 IP 정보는 3개 서버 같은 정보로 입력합니다.
scope는 클러스터 전체를 가리키는 이름으로, 3대 patroni.yml 모두 pg-cluster로 동일하게 입력합니다. name은 그 클러스터 안에서 이 노드를 구분하는 고유한 이름으로, 서버마다 pg_server1/pg_server2/pg_server3으로 다르게 입력합니다. 이 두 값은 이후 patronictl list/restart/switchover/failover 등의 명령에서 각각 클러스터명과 노드명 인자로 그대로 사용됩니다.
- scope: 클러스터명
- name: 노드명
etcd3는 etcd의 통신 프로토콜(API) 버전을 가리키며, v2/v3 API를 둘 다 지원하지만, 요즘은 v2 API가 사실상 폐기(deprecated)된 상태라 v3 API를 쓰는 etcd3 섹션으로 기재하였습니다.
아래 3개 블록 모두 authentication.superuser.password 값이 비어 있는데, 이는 실제 값이 아니라 채워 넣어야 할 자리표시자입니다. 초기 Leader 클러스터 초기화 단계에서 initdb --pwprompt로 직접 입력했던 postgres 비밀번호를 3대 patroni.yml에 동일하게 넣어야 하며, 빈 값으로 그대로 두면 Patroni가 postgres 계정으로 로컬 PostgreSQL에 헬스체크 접속할 때 scram-sha-256 인증에 실패합니다.
비밀번호가 기억나지 않는다면 pg_server1에서 로컬 소켓의 peer 인증으로 접속해 ALTER ROLE postgres WITH PASSWORD 구문으로 새 비밀번호를 설정하면 되는데, 이 경우에는 3대 patroni.yml 모두에 그 새 비밀번호를 동일하게 반영하고 patroni를 재시작해야 합니다.
pg_server1
sudo mkdir -p /etc/patroni
sudo tee /etc/patroni/patroni.yml > /dev/null <<'EOF_PATRONI'
scope: pg-cluster
name: pg_server1

log:
  dir: /data/patroni
  level: INFO

restapi:
  listen: 192.168.56.3:8008
  connect_address: 192.168.56.3:8008

etcd3:
  hosts:
    - 192.168.56.3:2379
    - 192.168.56.4:2379
    - 192.168.56.5:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: logical
        wal_log_hints: 'on'
        hot_standby: 'on'
        max_wal_senders: 10
        max_replication_slots: 10

postgresql:
  listen: 192.168.56.3:5432
  connect_address: 192.168.56.3:5432
  data_dir: /data/pgdata/17
  bin_dir: /usr/pgsql-17/bin
  authentication:
    replication:
      username: replicator
      password: Replicator@2026
    superuser:
      username: postgres
      password: ''
EOF_PATRONI
pg_server2
sudo mkdir -p /etc/patroni
sudo tee /etc/patroni/patroni.yml > /dev/null <<'EOF_PATRONI'
scope: pg-cluster
name: pg_server2

log:
  dir: /data/patroni
  level: INFO

restapi:
  listen: 192.168.56.4:8008
  connect_address: 192.168.56.4:8008

etcd3:
  hosts:
    - 192.168.56.3:2379
    - 192.168.56.4:2379
    - 192.168.56.5:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: logical
        wal_log_hints: 'on'
        hot_standby: 'on'
        max_wal_senders: 10
        max_replication_slots: 10

postgresql:
  listen: 192.168.56.4:5432
  connect_address: 192.168.56.4:5432
  data_dir: /data/pgdata/17
  bin_dir: /usr/pgsql-17/bin
  authentication:
    replication:
      username: replicator
      password: Replicator@2026
    superuser:
      username: postgres
      password: ''
EOF_PATRONI
pg_server3
sudo mkdir -p /etc/patroni
sudo tee /etc/patroni/patroni.yml > /dev/null <<'EOF_PATRONI'
scope: pg-cluster
name: pg_server3

log:
  dir: /data/patroni
  level: INFO

restapi:
  listen: 192.168.56.5:8008
  connect_address: 192.168.56.5:8008

etcd3:
  hosts:
    - 192.168.56.3:2379
    - 192.168.56.4:2379
    - 192.168.56.5:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: logical
        wal_log_hints: 'on'
        hot_standby: 'on'
        max_wal_senders: 10
        max_replication_slots: 10

postgresql:
  listen: 192.168.56.5:5432
  connect_address: 192.168.56.5:5432
  data_dir: /data/pgdata/17
  bin_dir: /usr/pgsql-17/bin
  authentication:
    replication:
      username: replicator
      password: Replicator@2026
    superuser:
      username: postgres
      password: ''
EOF_PATRONI
systemd 생성(3대 공통)
pip 설치는 systemd를 생성하지 않으므로 다음과 같이 직접 생성합니다.
sudo tee /etc/systemd/system/patroni.service > /dev/null <<'EOF_SERVICE'
[Unit]
Description=Patroni PostgreSQL HA
After=network.target

[Service]
Type=simple
User=postgres
ExecStart=/usr/local/bin/patroni /etc/patroni/patroni.yml
Restart=on-failure

[Install]
WantedBy=multi-user.target
EOF_SERVICE

sudo systemctl daemon-reload
PostgreSQL 중지 후 Patroni로 기동 (3대)
Patroni 구성후 PostgreSQL의 시작 및 중지와 같은 컨트롤은 이제 Patroni 를 통해서 이루어져야합니다. 그에 따라서 별도로 구동한 postgresql을 종료하고 Patroni 에 의해서 PostgreSQL을 구동하도록 하겠습니다.
3대 모두에서 기존 PostgreSQL 인스턴스를 중지하고 Patroni로 전환합니다.
# 기존 PostgreSQL 인스턴스 중지 및 자동시작 비활성화 (Patroni가 직접 관리하므로)
sudo systemctl stop postgresql-17
sudo systemctl disable postgresql-17
pg_server1 먼저 -> Leader 확인 후 pg_server2, pg_server3 순으로 기동합니다.
# Patroni 기동
sudo systemctl enable --now patroni

#
sudo systemctl status patroni
클러스터 상태 확인 (아무 서버에서나)
patronictl -c /etc/patroni/patroni.yml list

정상 결과 예시
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Leader  | running   |  2 |             |     |            |     |
| pg_server2 | 192.168.56.4 | Replica | streaming |  2 |   0/9000510 |   0 |  0/9000510 |   0 |
| pg_server3 | 192.168.56.5 | Replica | streaming |  2 |   0/9000510 |   0 |  0/9000510 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
복제 슬롯은 이제부터 Patroni가 관리합니다. Patroni는 DCS(etcd)에 등록된 클러스터 멤버 목록을 보고, 현재 Leader 노드에 나머지 멤버 각각을 위한 물리 복제 슬롯을 자동으로 생성·관리합니다.
슬롯 이름은 복제 연결시 지정한 rs_node2_physical/rs_node3_physical이 아니라 patroni.yml에 설정한 멤버 이름(name:) 기준으로 Patroni가 자체적으로 만듭니다. failover로 다른 노드가 새 Leader가 되면 그 노드에서도 Patroni가 똑같이 나머지 멤버들 슬롯을 자동으로 다시 만들어주므로, 이후로는 사람이 슬롯을 손댈 일이 없습니다.
Patroni가 기동되면 이름이 다른 자체 슬롯을 새로 만들어 쓰므로, rs_node2_physical/rs_node3_physical은 더 이상 쓰이지 않는 고아 슬롯으로 남을 수 있습니다. 아래로 먼저 확인합니다.
sudo -u postgres psql -c "SELECT slot_name, active FROM pg_replication_slots;"
Patroni 동작 테스트
이제 PostgreSQL 복제 구성 + Patroni + etcd 를 통한 고가용성 클러스터가 구성되었기 때문에 Patroni에 의한 동작 테스트를 수행하도록 하겠습니다.
PostgreSQL 프로세스만 종료 시 자동 재시작
다음과 같이 PostgreSQL 임의 종료를 해보도록 하겠습니다.
sudo -u postgres /usr/pgsql-17/bin/pg_ctl -D /data/pgdata/17 stop

# 확인
patronictl -c /etc/patroni/patroni.yml list

# 확인
ps -ef | grep postgres
위와 같은 절차로 확인해보면 Patroni에 의해서 즉시 재기동시킵니다 (Failover 아님)
Patroni가 관리하는 PostgreSQL 재시작/정지/시작 (patronictl)
Patroni가 PostgreSQL을 직접 관리하는 노드에서는 systemctl restart/start/stop postgresql-17을 사용하면 안 됩니다. Patroni가 이미 해당 데이터 디렉터리와 포트를 점유한 상태이므로, systemd의 postgres 기동 시도는 포트/락 파일 충돌로 바로 실패합니다("Start request repeated too quickly" 에러로 나타납니다).
Patroni를 통한 PostgreSQL 재시작
patronictl -c /etc/patroni/patroni.yml restart pg-cluster pg_server1
Patroni를 통해 PostgreSQL만 종료
Patroni가 기동된 상태에서 pg_ctl로 PostgreSQL을 직접 중지하면 Patroni가 헬스체크 실패를 감지하고 즉시 다시 PostgreSQL을 기동합니다. Patroni 프로세스는 그대로 둔 채 PostgreSQL만 정지하는 명령은 patronictl에 따로 없으므로, 먼저 클러스터를 pause해서 Patroni의 자동 관리(재시작, failover)를 잠시 중지 한 다음 PostgreSQL을 중지합니다.
patronictl -c /etc/patroni/patroni.yml pause pg-cluster --wait

sudo -u postgres /usr/pgsql-17/bin/pg_ctl -D /data/pgdata/17 stop -m fast
pause는 노드 단위가 아니라 클러스터 전역 설정이라, pause 중에는 다른 노드에 장애가 나도 자동 failover가 일어나지 않습니다. 작업이 끝나면 pg_ctl로 PostgreSQL을 다시 띄운 뒤 반드시 resume으로 되돌려야 합니다.
sudo -u postgres /usr/pgsql-17/bin/pg_ctl -D /data/pgdata/17 start

patronictl -c /etc/patroni/patroni.yml resume pg-cluster
특정 노드를 중지할 경우(Patroni+PostgreSQL)
특정 노드를 완전히 멈추고 싶을 때는 patroni 자체를 중지하면 PostgreSQL까지 중지됩니다.
sudo systemctl stop patroni
중지된 Patroni 노드를 실행은 다음과 같습니다.
sudo systemctl start patroni
참고로 postgresql.service는 Patroni로 전환한 뒤로는 사용하지 않으므로, enable 상태로 남아있지 않은지 확인해둡니다(남아있으면 재부팅 시 충돌이 발생하게 됩니다.)
systemctl is-enabled postgresql-17
Failover 테스트 (Patroni 프로세스 종료)
pg_server1/2/3 중 어느 서버가 현재 Leader인지는 고정돼 있지 않고 Patroni가 그때그때 동적으로 정합니다. 먼저 아래로 현재 Leader가 어느 서버인지 확인합니다.
patronictl -c /etc/patroni/patroni.yml list
결과에서 Role이 Leader로 나온 서버에 접속해서 그 서버에서만 아래 명령을 실행합니다.
sudo systemctl stop patroni
다른 서버에서 아래로 확인합니다. 방금 중지한 서버를 제외한 나머지 두 서버 중 하나가 새 Leader로 자동 승격됩니다.
patronictl -c /etc/patroni/patroni.yml list
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Replica | stopped   |    |     unknown |     |    unknown |     |
| pg_server2 | 192.168.56.4 | Leader  | running   |  3 |             |     |            |     |
| pg_server3 | 192.168.56.5 | Replica | streaming |  3 |   0/9000618 |   0 |  0/9000618 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
장애복구는 중지된 Patroni 서비스를 다시 시작하면 복구가 완료됩니다.
sudo systemctl start patroni
새 Leader 아래 Replica로 자동 복귀하는지 확인합니다.
patronictl -c /etc/patroni/patroni.yml list
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Replica | streaming |  3 |   0/9000720 |   0 |  0/9000720 |   0 |
| pg_server2 | 192.168.56.4 | Leader  | running   |  3 |             |     |            |     |
| pg_server3 | 192.168.56.5 | Replica | streaming |  3 |   0/9000720 |   0 |  0/9000720 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
기본적인 PostgreSQL 복제 구성에서는 복제 슬롯이 사람이 직접 지우기 전까지 계속 유지되므로, 노드가 멈춰 있는 동안 Leader는 그 슬롯이 아직 소비하지 못한 WAL을 지우지 않고 무한정 쌓아둡니다.
반면 Patroni가 관리하는 슬롯은 member_slots_ttl(기본값 30분)이 지나면 자동으로 삭제됩니다. 노드가 멈춰 있는 동안에는 WAL이 똑같이 쌓이지만 그 증가량은 최대 member_slots_ttl 만큼으로 제한되며, 이 시간이 지나면 슬롯이 삭제되어 더 이상 쌓이지 않습니다. 문제는 슬롯이 삭제된 뒤 Leader가 그 WAL을 재사용/삭제해버리면, 그 노드는 patronictl reinit으로 데이터 디렉터리를 지우고 pg_basebackup으로 처음부터 다시 구축해야 한다는 점입니다.
그러므로 member_slots_ttl 값을 기본값보다 넉넉하게 늘려두면, 예상치 못한 장애나 계획된 유지보수로 다운타임이 길어지는 경우에 대비할 수 있습니다.
노드가 member_slots_ttl 안에 복구되어 스트리밍을 다시 따라잡으면 밀려 있던 WAL은 정리됩니다.
계획된 Switchover (patronictl switchover)
Failover 테스트는 Leader의 Patroni 프로세스를 강제로 종료하여 장애 상황을 확인하였습니다. 반면 모든 노드가 정상인 상태에서 운영 작업(점검, 배포 등)을 이유로 계획적으로 Leader를 다른 노드로 넘기고 싶을 때는 switchover를 사용합니다. 현재 Leader의 프로세스를 종료 하지 않고, Patroni가 새 후보 노드와 조율해서 안전하게 역할을 교체합니다.
-
--leader에는 현재 실제 Leader인 서버 이름
-
--candidate에는 Leader를 넘겨받을 서버 이름을 지정
patronictl -c /etc/patroni/patroni.yml switchover --leader pg_server2 --candidate pg_server1
두개의 옵션을 생략하면 대화형으로 진행됩니다.
patronictl -c /etc/patroni/patroni.yml switchover
Current cluster topology
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Replica | streaming |  4 |   0/90008D8 |   0 |  0/90008D8 |   0 |
| pg_server2 | 192.168.56.4 | Leader  | running   |  4 |             |     |            |     |
| pg_server3 | 192.168.56.5 | Replica | streaming |  4 |   0/90008D8 |   0 |  0/90008D8 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Primary [pg_server2]:
Candidate ['pg_server1', 'pg_server3'] []: pg_server1
When should the switchover take place (e.g. 2026-10-24T12:58 )  [now]: now
Are you sure you want to switchover cluster pg-cluster, demoting current leader pg_server2? [y/N]: y
2026-10-24 11:58:36.71781 Successfully switched over to "pg_server1"
+ Cluster: pg-cluster (7698785563610687538) ----+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Leader  | running |  4 |             |     |            |     |
| pg_server2 | 192.168.56.4 | Replica | stopped |    |     unknown |     |    unknown |     |
| pg_server3 | 192.168.56.5 | Replica | running |  4 |   0/9000A20 |   0 |  0/9000A20 |   0 |
+------------+--------------+---------+---------+----+-------------+-----+------------+-----+


patronictl -c /etc/patroni/patroni.yml list
+ Cluster: pg-cluster (7698785563610687538) ------+----+-------------+-----+------------+-----+
| Member     | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| pg_server1 | 192.168.56.3 | Leader  | running   |  5 |             |     |            |     |
| pg_server2 | 192.168.56.4 | Replica | streaming |  5 |   0/9000B60 |   0 |  0/9000B60 |   0 |
| pg_server3 | 192.168.56.5 | Replica | streaming |  5 |   0/9000A20 |   0 |  0/9000A20 |   0 |
+------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
실행하면 마지막에 "Are you sure you want to switchover cluster pg-cluster, demoting current leader pg_server1? [y/N]"처럼 확인을 요구하는데, y를 입력해야 실제로 진행됩니다.
확인 절차 없이 바로 실행하려면 --force를 추가합니다. 진행 결과는 아래로 확인합니다.
patronictl -c /etc/patroni/patroni.yml list
지정한 --candidate 서버가 새 Leader로, 기존 Leader였던 서버는 Replica로 바뀌어 있으면 정상입니다.
switchover는 Leader가 살아있는 정상 상태에서만 됩니다. Leader가 이미 죽어서 DCS에 Leader가 없는 비정상 상황에는 switchover 대신 patronictl failover --candidate <서버이름>을 사용합니다.
Summary&Reference
이번글에서는 PostgreSQL 데이터베이스에 대해서 고가용성 시스템 구성을 위해서 PostgreSQL + Patroni + etcd 에 대한 내용과 구성등의 내용을 확인해보았습니다.
3개의 별도의 프로그램이 연동에 사용하기 위한 필요한 통신 포트 및 필요 설정 및 구성을 알아보았으며 구성 후 Failover 및 Switchover 에 대해서 확인해보았습니다.
고가용성 시스템은 크게 서버측면과 클라이언트측면 모두에서 구성 또는 고려가 필요합니다. 이번 글은 그 중에서 서버측면에서의 고가용성 시스템을 구성하는 내용을 다루었습니다. 이어서 다음 글에는 클라이언트측면에서 고가용성 시스템을 구현하는 내용을 다루도록 하겠습니다.
Reference
- PostgreSQL 17 Streaming Replication 공식 문서
- Patroni 공식 문서
- PgBouncer 공식 문서
- HAProxy 공식 문서
- Keepalived 공식 문서
Principal DBA(MySQL, AWS Aurora, Oracle)
핀테크 서비스인 핀다에서 데이터베이스를 운영하고 있어요(at finda.co.kr)
Previous - 당근마켓, 위메프, Oracle Korea ACS / Fedora Kor UserGroup 운영중
Database 외에도 NoSQL , Linux , Python, Cloud, Http/PHP CGI 등에도 관심이 있습니다
purityboy83@gmail.com / admin@hoing.io