



Last Updated on 10월 16, 2026 by Jade(정현호)
MySQL Innovation 릴리스는 기존 순차 버전 대신 YY.M 형식의 달력 기반 버전 체계로 전환된다는 소식을 블로그 글을 통해 알렸습니다.
예를 들어 26.7은 2026년 7월, 26.10은 2026년 10월 Innovation 릴리스를 의미합니다. 이에 따라 새로운 버전 체계로 처음 소개되는 Innovation 릴리스는 26.7입니다. 새로운 Innovation 26.7 릴리즈부터 Community Edition에 Thread Pool 기능이 포함되게 되었습니다.
이번 글은 Community Edition 에서도 사용이 가능해진 MySQL의 Thread Pool(스레드 풀) 기능에 대한 내용과 적용 가능성 등을 테스트한 내용의 글입니다.
Thread Pool
Thread Pool 개요
MySQL 26.7 버전부터 Thread Pool Plugin 이 Community Edition 에 포함되었습니다. 그동안 Enterprise Edition 에서만 제공되던 기능이라 상용 라이선스가 없으면 확인할 수 없었는데, 이번 26.7 버전부터는 Community Edition 에서도 사용할 수 있게 되었습니다.
Thread Pool 은 커넥션마다 스레드를 만드는 대신, 정해진 수의 스레드가 여러 커넥션의 쿼리를 나누어 실행하는 방식입니다. 동시에 실행되는 스레드 수를 CPU 가 처리할 수 있는 수준으로 줄여 두는 것이 목적입니다. 커넥션이 몇 개가 되든 실행 스레드는 정해진 수만큼만 두고 나머지는 차례를 기다리게 합니다.
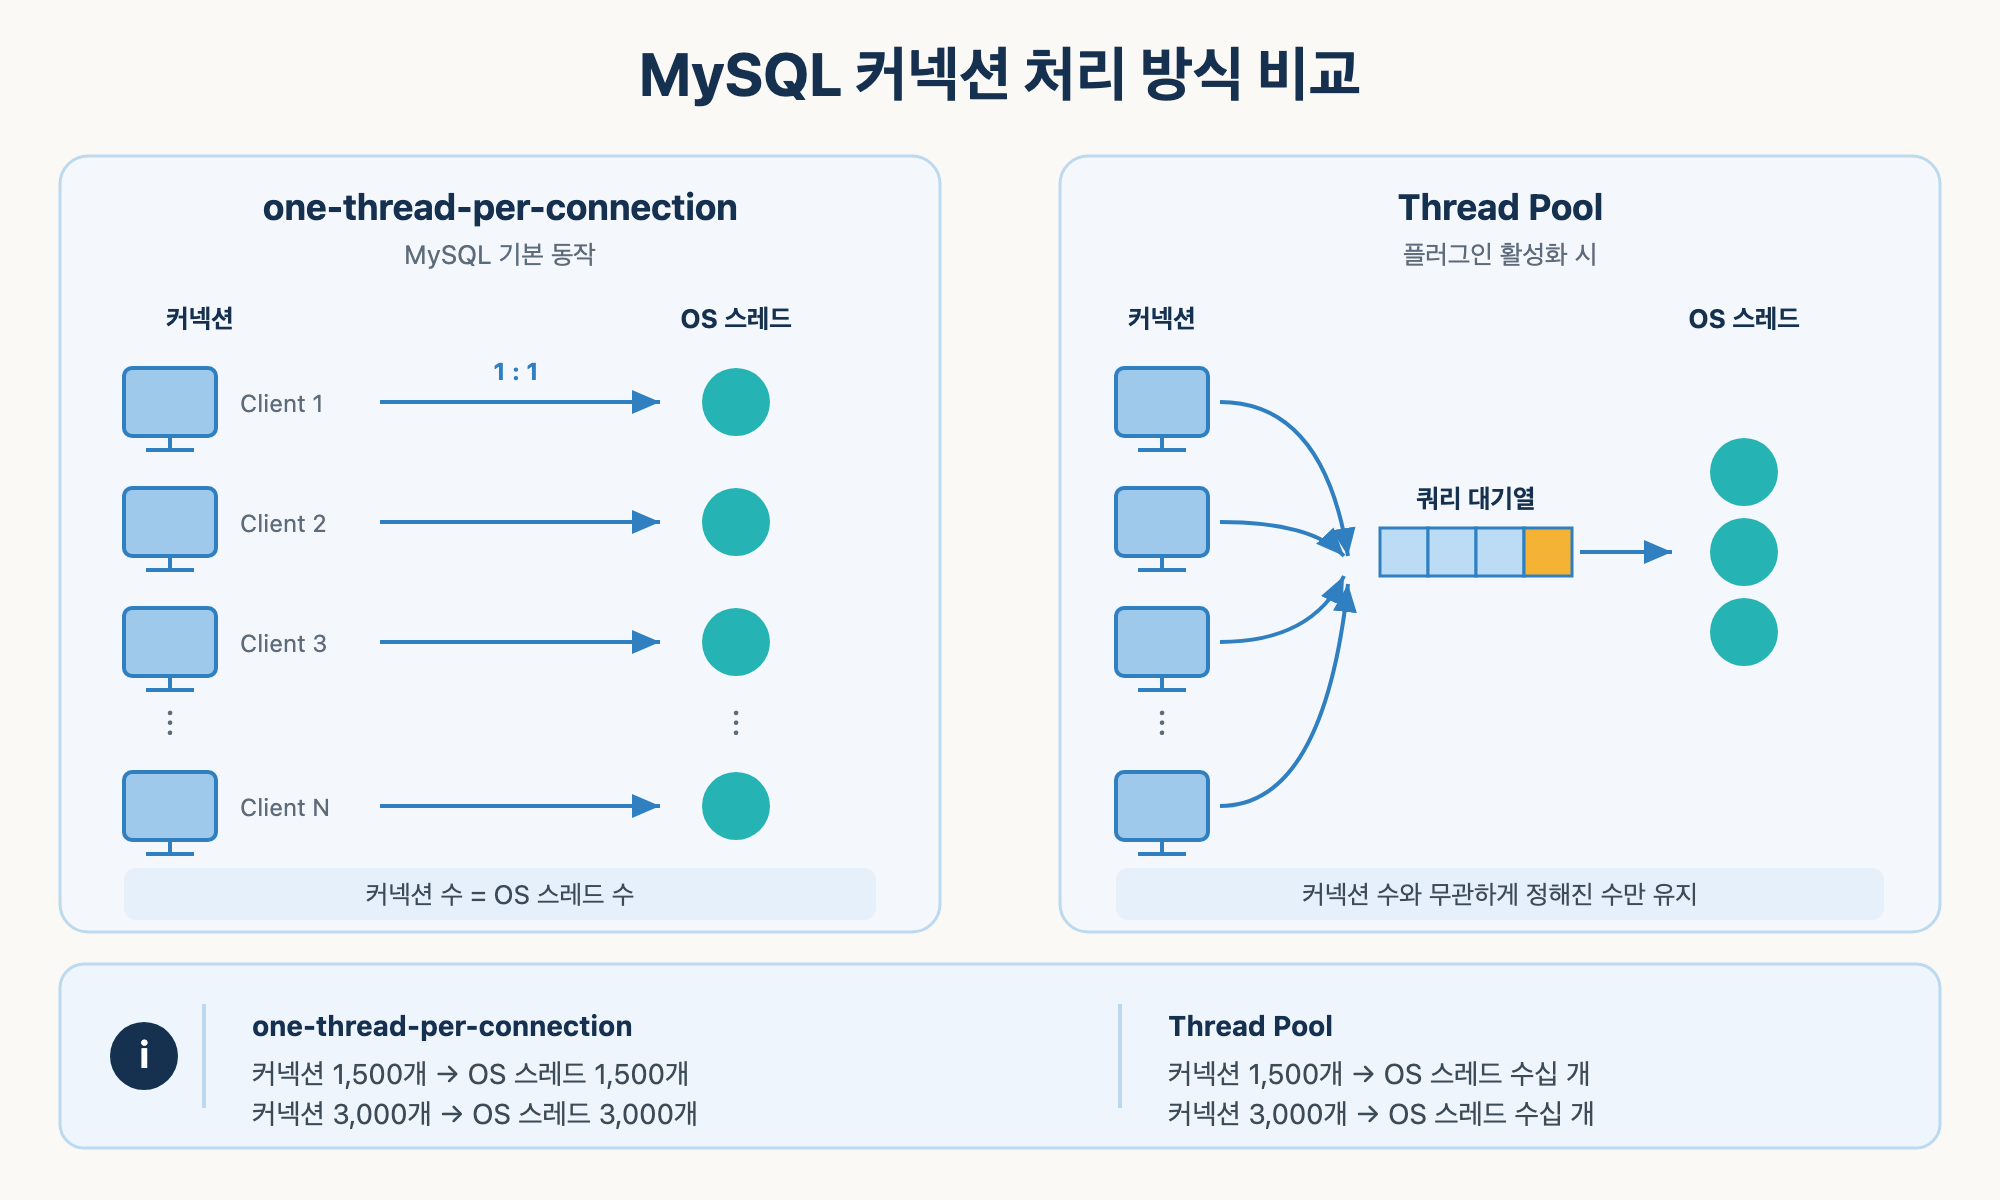
Thread Pool 을 사용하지 않는 MySQL 의 기본 동작은 이와 다릅니다. 클라이언트 커넥션마다 전용 OS 스레드를 하나씩 만드는 one-thread-per-connection 모델입니다. 사용자가 서버에 접속하면 그 커넥션 전용 스레드가 생성되고, 접속이 종료될 때까지 이 스레드가 해당 세션의 모든 쿼리를 실행하고 결과를 반환합니다.
이 방식은 구조가 단순하고 커넥션 수가 많지 않은 환경에서는 효율적입니다. 커넥션과 스레드가 1:1로 대응되므로 중간 처리 단계가 존재하지 않습니다.
다만 커넥션 수가 증가하면 OS 스레드 수도 같이 증가합니다. 실제로 쿼리를 실행하는 커넥션이 일부뿐이어도 나머지 스레드는 그대로 남아 메모리를 쓰고 스케줄러의 관리 대상으로 유지됩니다. 그래서 스레드 수를 늘리는 것은 어느 지점까지만 유효합니다.
같은 커넥션 수에서 두 방식의 차이는 이렇습니다.
- one-thread-per-connection
- 커넥션 1,500개 -> OS 스레드 1,500개
- 커넥션 3,000개 -> OS 스레드 3,000개
- Thread Pool
- 커넥션 1,500개 -> OS 스레드 수십 개
- 커넥션 3,000개 -> OS 스레드 수십 개
- 커넥션 수가 증가해도 쿼리를 실행하는 스레드 수는 거의 변하지 않습니다.
Thread Pool은 서버 플러그인으로 구현되어 있으며 기본적으로 활성화되어 있지 않습니다. 설치 후 별도로 활성화하지 않으면 기존 one-thread-per-connection 모델로 동작합니다.
Community Edition 포함은 26.7 Early Access 에서 처음 공개되었고, 2026년 7월 26.7.0 GA 릴리스에 포함되었습니다. 플러그인 자체는 기존 MySQL 기능이므로 Enterprise 환경의 설정 변수와 튜닝 방식이 그대로 적용됩니다. 설치 및 튜닝 세부 사항은 26.7 문서와 릴리스 노트에 정리되어 있습니다. 이 문서를 작성하는 시점 기준으로 Amazon RDS 와 Aurora MySQL 에서는 아직 제공되지 않습니다.
Thread Pool 의 초기 설계는 MySQL 5.6 시점의 요구 사항을 대상으로 한 것입니다. 이후 서버 내부의 락 구조와 알고리즘이 개선되면서 초기 설계가 제공하던 이점은 줄어들었으나, MySQL 8.0 에서 추가된 Max Transaction Limit 기능으로 Thread Pool 의 적용 가능성이 높아졌습니다.
지금의 Thread Pool 은 두 부분으로 이루어져 있습니다.
1. 커넥션과 스레드의 분리 — 초기 Thread Pool 설계
2. 동시 실행 트랜잭션 수 제한 — Max Transaction Limit
이에 대한 내용은 글에서 계속적으로 다루도록 하겠습니다.
[참고] 글에서 파라미터 기본값 정보나 기타 정보는 26.7 버전 기준으로 설명합니다.
one-thread-per-connection 모델
MySQL의 기본 스레드 처리 모델에서는 커넥션과 스레드가 1:1로 대응합니다.
Application
   │
   ├── Connection 1 ─────── Thread 1
   ├── Connection 2 ─────── Thread 2
   ├── Connection 3 ─────── Thread 3
   │        ...
   └── Connection 1000 ──── Thread 1000
커넥션이 1,000개라고 해서 1,000개가 항상 CPU를 사용하지는 않습니다. 실제로 쿼리를 실행하는 커넥션은 일부이고 나머지는 대기 상태인 경우가 일반적입니다.
1,000 connections
       ↓
실제로 query를 실행 중인 것은 20개
       ↓
나머지 980개는 대기
그러나 대기 상태여도 OS 스레드는 소멸하지 않습니다. 스택 메모리를 유지하고 스케줄링 대상으로 남아 있습니다.
스레드가 대기하는 대상
스레드는 대기가 필요한 시점에 도달하거나 OS 스케줄러가 할당한 타임 슬라이스를 모두 사용할 때까지 명령을 실행합니다. 이때 스레드가 대기하게 되는 대상은 다음 세 가지입니다.
1. mutex — MySQL 내부 뮤텍스
2. database object lock — 행 락, 테이블 락
3. IO — 디스크 입출력
이 세 가지는 스레드 수를 늘려서 해소되는 대상이 아닙니다. 뮤텍스는 한 시점에 하나의 스레드만 획득할 수 있고, 행 락도 동일합니다. 디스크 대역폭 역시 고정되어 있습니다. 대기하는 스레드가 늘어나면 대기열만 길어집니다.
모델의 한계
one-thread-per-connection 모델에서 커넥션 수가 늘어날 때 발생하는 문제는 다음과 같습니다.
| 문제 | 내용 | Thread Pool 의 대응 |
| 스레드 스택 과다 | 스레드마다 스택이 있어 병렬도가 높아지면 CPU 캐시 적중률이 떨어집니다 | 스택을 재사용해 캐시가 다룰 영역을 줄입니다 |
| 컨텍스트 스위칭 증가 | 실행 가능한 스레드가 코어 수보다 많으면 OS 가 짧은 주기로 교체합니다. 스케줄러 부담도 함께 커집니다 | 활성 스레드 수를 감당 가능한 수준으로 유지합니다 |
| InnoDB 자원 경합 | 병렬 트랜잭션이 많을수록 중앙 뮤텍스를 점유하는 시간이 길어집니다 | 트랜잭션이 시작되는 시점을 제어합니다 |
Thread Pool 구조
Thread Pool은 커넥션과 실행 스레드를 분리합니다. one-thread-per-connection에서는 커넥션 하나가 스레드 하나를 소유했지만, Thread Pool에서는 커넥션이 어느 스레드에서 실행될지 미리 정해져 있지 않습니다.
커넥션은 여러 개의 스레드 그룹 중 하나에 배정되고, 그룹에 속한 소수의 워커 스레드가 그 그룹에 배정된 커넥션들의 구문을 나누어 실행합니다. 커넥션이 1,000개든 3,000개든 실제로 쿼리를 실행하는 스레드 수는 그룹 수와 그룹당 실행 스레드 수로 결정됩니다.
다음은 접속부터 실행까지의 흐름입니다.
1. 클라이언트가 접속을 요청합니다.
2. Receiver Thread가 요청을 받아 커넥션을 스레드 그룹에 배정합니다.
3. 커넥션이 구문을 보내면 배정된 그룹이 이를 받습니다.
4. 즉시 실행할 수 있으면 실행하고, 아니면 그룹의 큐에서 대기합니다.
5. 그룹의 워커 스레드가 큐에서 구문을 꺼내 실행합니다.
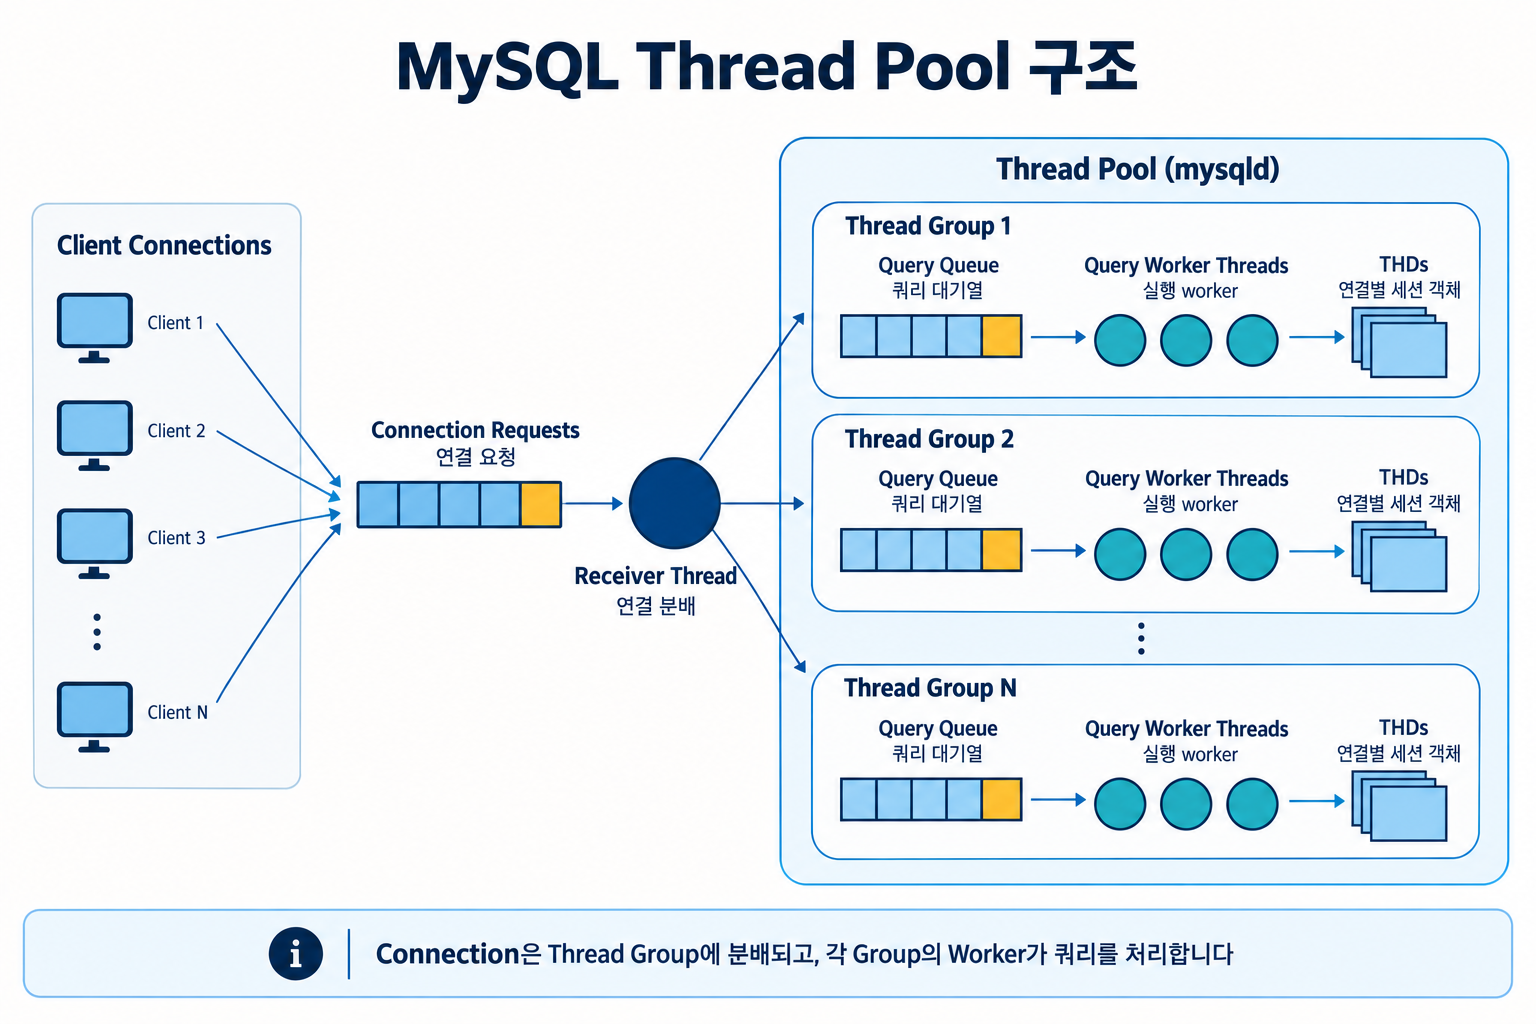
그림에 나오는 요소는 다음과 같습니다.
| 요소 | 역할 |
| Client | MySQL 클라이언트 프로토콜로 서버와 통신하는 도구 또는 애플리케이션입니다 |
| Connection Request | 클라이언트가 서버로 전송한 접속 요청입니다 |
| Receiver Thread | 접속 요청을 큐에 넣고 순차적으로 처리하며, 커넥션을 스레드 그룹에 라운드 로빈 방식으로 배정합니다 |
| Thread Group | 커넥션의 부분집합을 관리하는 단위입니다. 기본값은 16개이며 thread_pool_size로 지정합니다 |
| Query Queue | 그룹 내에서 즉시 실행되지 못한 구문이 대기하는 큐입니다 |
| Query Worker Thread | 그룹에 배정된 커넥션의 쿼리를 실행하는 스레드입니다 |
| THD | 커넥션마다 생성되는 스레드 컨텍스트 자료구조입니다 |
여기에서 THD와 워커 스레드의 관계를 구분할 필요가 있습니다. THD는 커넥션 수만큼 존재하지만 워커 스레드는 그보다 훨씬 적습니다. 커넥션 1,500개가 THD 1,500개를 갖더라도 실제로 쿼리를 실행하는 OS 스레드는 수십 개 수준입니다.
그룹은 서로 독립적으로 동작합니다. 각 그룹이 자기 큐와 자기 스레드를 가지므로 그룹 사이를 조율할 필요가 없고, 한 그룹이 혼잡해도 다른 그룹의 실행에는 영향을 주지 않습니다. 반대로 특정 그룹에 무거운 커넥션이 몰리면 전체 스레드에는 여유가 있어도 그 그룹에 배정된 커넥션만 밀리게 됩니다.
스레드 그룹의 동작
커넥션 배정
Receiver Thread가 새 커넥션을 스레드 그룹에 라운드 로빈 방식으로 배정합니다. 한 번 배정된 커넥션은 해당 그룹에 유지되며, 특정 그룹이 혼잡하다고 해서 다른 그룹으로 이동하지 않습니다.
Connection  1 -> Group 1
Connection  2 -> Group 2
Connection  3 -> Group 3
     ...
Connection 16 -> Group 16
Connection 17 -> Group 1
구문의 실행 시작
커넥션이 배정된 뒤 실제로 구문을 보내면, 그 구문을 받는 것은 그룹의 listener 스레드입니다. 그룹마다 listener 역할을 하는 스레드가 하나씩 있어 해당 그룹에 배정된 커넥션들의 구문 도착을 감시합니다.
listener는 별도로 존재하는 스레드가 아닙니다. 워커 스레드가 돌아가면서 맡는 역할입니다. 앞의 그림에 listener가 없는 것도 이 때문입니다.
구문이 도착하면 그룹은 둘 중 하나를 선택합니다.
1. 즉시 실행 — 대기 중이거나 실행 중인 구문이 없고 방금 도착한 구문 하나뿐일 때
2. 큐 대기 — 그 외의 경우
즉시 실행에 해당하면 listener 스레드가 그 구문을 직접 실행합니다. 실행하는 동안 그 그룹에는 구문 도착을 감시하는 스레드가 없습니다. 구문이 빨리 끝나면 같은 스레드가 다시 감시 역할로 돌아가므로 스레드를 추가로 만들 필요가 없습니다. 동시 실행 수가 적을 때 스레드 생성 비용을 들이지 않으려는 설계입니다.
구문이 빨리 끝나지 않으면 Thread Pool은 그 구문을 stall 상태로 판단하고 다른 스레드에 listener 역할을 넘깁니다. 넘길 스레드가 없으면 새로 만듭니다. 이 판단 기준이 thread_pool_stall_limit 입니다.
그룹이 stall된 구문 때문에 막히지 않도록, Thread Pool은 별도의 백그라운드 스레드로 각 그룹의 상태를 주기적으로 확인합니다.
수신만 전담하는 스레드를 따로 두는 방법도 있습니다. thread_pool_dedicated_listeners 입니다. 이 파라미터는 뒤에서 따로 다룹니다.
그룹 내 동시 실행 제한
그룹마다 동시에 실행할 수 있는 쿼리 스레드 수가 제한됩니다. thread_pool_query_threads_per_group으로 지정하며 기본값은 2 입니다. MySQL 8.4 까지는 1 이었습니다. 이 수를 초과하는 구문은 큐에서 대기합니다.
기본값이 2라는 것은 그룹 안에서 한 번에 두 개까지만 실행된다는 뜻입니다. 그룹 수가 16이면 서버 전체에서 동시에 실행되는 쿼리는 32개입니다. 내부 뮤텍스와 락을 두고 경합하는 스레드 수를 그만큼 줄이겠다는 설계입니다.
전체적으로는 다음 관계가 성립합니다.
쿼리 처리에 사용되는 스레드 수 ≒ thread_pool_size × thread_pool_query_threads_per_group
커넥션 수가 늘어도 이 값은 변하지 않습니다. 기본값으로 두면 이렇게 됩니다.
| 커넥션 수 | one-thread-per-connection | Thread Pool (size 16, per_group 2) |
| 100 | 100 | 32 |
| 1,000 | 1,000 | 32 |
| 3,000 | 1,000 | 32 |
커넥션이 30배로 늘어도 실제로 쿼리를 실행하는 스레드는 32개 그대로입니다. Thread Pool이 부하 증가로부터 서버를 보호하는 방식입니다.
다만 이 제한은 그룹 단위로 걸립니다. 긴 쿼리 두 개가 같은 그룹을 채우면 그 그룹에 배정된 다른 커넥션의 구문은 큐에서 기다립니다. 이 대기는 앞에서 본 것처럼 stall로 판정될 때까지입니다. 그룹 수와 per_group을 어떻게 나눌지는 뒤에서 따로 다룹니다.
Max Transaction Limit
도입 배경
Thread Pool의 초기 설계는 앞에서 본 세 가지 문제를 대상으로 한 것입니다. 스레드 스택 과다, 컨텍스트 스위칭 증가, InnoDB 자원 경합입니다. MySQL 5.6 시점에는 이 문제들이 컸기 때문에 실행 스레드 수를 묶는 것만으로도 효과가 있었습니다.
Oracle은 이후 상황을 다음과 같이 설명합니다.
The original design of the thread pool addressed the needs of MySQL 5.6, but as the MySQL server locking structures and algorithms have been improved over time the additional benefits provided by the original thread pool design have been reduced. The Max Transaction Limit feature in the MySQL 8.0 thread pool revitalizes the thread pool as a customer tool.
Thread Pool의 초기 설계는 MySQL 5.6의 요구 사항을 대상으로 한 것이었습니다. 그러나 시간이 지나면서 MySQL 서버의 락 구조와 알고리즘이 개선되었고, 초기 Thread Pool 설계가 제공하던 추가적인 이점은 줄어들었습니다. MySQL 8.0 Thread Pool의 Max Transaction Limit 기능은 Thread Pool을 다시 활용 가능한 도구로 만들었습니다.
여기서 말하는 개선은 서버 내부의 락 구조입니다. 5.6버전 시절에는 InnoDB와 서버 레이어의 중앙 집중 락이 병목이었기 때문에 동시 스레드를 줄이는 것만으로도 효과가 컸습니다. 이후 버전에서 그 락들이 쪼개지고 세분화되면서 서버 자체가 높은 동시성을 더 잘 견디게 되었고, 그만큼 스레드 수를 줄여서 얻는 이득이 작아졌습니다.
동작 방식
thread_pool_max_transactions_limit에 0이 아닌 값 N을 지정하면, 어느 시점에도 동시 실행 트랜잭션이 N개를 초과하지 않습니다.
thread_pool_max_transactions_limit = N
                 ↓
동시 실행 트랜잭션 ≤ N
                 ↓
동시에 점유되는 데이터 락 수 감소
                 ↓
데드락 발생 감소, 전체 처리량 방어
상한은 스레드 그룹에 균등하게 분배됩니다.
그룹당 동시 트랜잭션 수 = CEIL(thread_pool_max_transactions_limit / thread_pool_size)
나누어떨어지지 않으면 올림 처리되므로, 상한 값은 thread_pool_size의 배수로 지정하는 것이 적절합니다.
그룹별로 나뉘어 적용되므로 전체 실행 트랜잭션 수가 상한보다 적은 상태에서도 특정 그룹이 자기 몫을 다 쓰고 있으면 그 그룹에 배정된 커넥션은 대기합니다.
트랜잭션이 실행되기 시작하면 워커 스레드는 구문 하나를 완료한 뒤 다른 커넥션의 큐를 확인하지 않고 같은 트랜잭션의 다음 구문을 먼저 선택합니다. 트랜잭션을 조기에 종료시켜 락을 빠르게 해제하도록 하는 설계입니다.
주의 사항
상한에 도달하면 신규 스레드를 생성하지 않습니다. 새로 들어온 커넥션과 트랜잭션은 기존 트랜잭션이 끝날 때까지 기다립니다.
When the maximum number of transactions are executing concurrently, new connections and transactions/queries must wait until existing transactions are completed. No new threads are created to handle new requests. If all concurrent transactions consist of long-running queries, it may appear as if the MySQL system is stalled.
최대 트랜잭션 수가 동시에 실행되고 있으면 새로운 커넥션과 트랜잭션, 쿼리는 기존 트랜잭션이 완료될 때까지 기다려야 합니다. 새 요청을 처리하기 위한 스레드는 생성되지 않습니다. 동시에 실행 중인 트랜잭션이 모두 장시간 쿼리라면 MySQL 시스템이 멈춘 것처럼 보일 수 있습니다.
동시 실행 중인 트랜잭션이 모두 장시간 쿼리라면 서버가 멈춘 것처럼 보입니다. 이때를 위해 TP_CONNECTION_ADMIN 권한을 가진 커넥션은 상한을 우회하여 접속할 수 있습니다. 이 커넥션으로 상한을 올리거나 대기를 유발하는 쿼리를 종료합니다.
하나의 인스턴스에 독립적인 데이터베이스가 여러 개 있으면 서로 간섭합니다. 상한이 인스턴스 전체에 하나뿐이므로, 한 데이터베이스의 쿼리가 다른 데이터베이스의 쿼리 때문에 밀릴 수 있습니다.
파라미터값 변경
이 파라미터는 Dynamic 변수라 재시작 없이 SET GLOBAL 로 바꿀 수 있습니다. 공식 문서에는 0 과 0 이 아닌 값 사이는 런타임에 전환할 수 없다고 적혀 있으나, 26.7버전에서 확인했을때 실제로는 전환이 가능한걸로 확인하였습니다.
0 은 동시 실행 트랜잭션 수에 상한을 두지 않는다는 의미입니다. 이 상태에서는 Max Transaction Limit 이 적용되지 않습니다. 8.4 까지는 이 값이 기본값이었고, 9.7 부터 기본값이 MIN(32 × thread_pool_size, 512) 로 바뀌었습니다.
0 이 아닌 값은 그 수를 상한으로 삼는다는 의미입니다. 어느 시점에도 동시에 실행되는 트랜잭션이 그 수를 넘지 않습니다.
운영 중에 제한을 풀어야 할 경우가 생기거나 정책이 변경되는 경우가 있을 수도 있습니다. 26.7 버전에서는 0 으로 바꾸면 되고 재시작은 필요하지 않습니다.
권장 초기 설정
Thread Pool 을 처음 적용할 때 어떤 값부터 시작해야 할지 판단이 어려울 수 있습니다. Oracle 공식 블로그 글에 따르면 시작시 사용할 수 있는 값이 아래와 같이 제시되어 있습니다.
| 변수 | 권장값 |
| thread_pool_size | 물리 코어 수, 최대 512 |
| thread_pool_max_transactions_limit | 물리 코어 수 × 32, 최대 512 |
| thread_pool_algorithm | 1 (high concurrency algorithm) |
| thread_pool_query_threads_per_group | 2 |
블로그 본문에는 thread_pool_query_worker_threads_per_group 으로 기재되어 있으나, 확인되는 실제 변수명은 thread_pool_query_threads_per_group 으로 확인됩니다.
상한 값 결정 절차
위 표에서 thread_pool_size 와 알고리즘은 하드웨어 사양에서 바로 정해지지만, 상한은 워크로드에 따라 달라집니다. 상한은 서버가 가장 많은 처리량을 내는 동시성 수준에서 잡습니다. Oracle 블로그에서는 다음과 같이 설명합니다.
the default thread handling model performance peaks at 64 concurrent users, so a Max Transaction Limit of 64 is chosen for this load.
기본 스레드 처리 모델의 성능이 64 동시 사용자에서 정점을 찍으므로, 이 부하에 대해서는 Max Transaction Limit 을 64 로 선택합니다.
측정은 Thread Pool 을 끈 상태에서 합니다. Thread Pool 이 켜져 있으면 상한 자체가 동시 실행 수를 제약하기 때문에 서버가 실제로 어디까지 처리량을 올릴 수 있는지 보이지 않습니다.
1. Thread Pool 을 비활성화한 상태에서 동시성을 단계적으로 높이며 측정합니다
2. 처리량이 정점에 도달하는 동시성 값을 확인합니다
3. 해당 값을 thread_pool_max_transactions_limit 으로 지정합니다
여기서 64 는 그 측정에 쓰인 장비와 워크로드에서 나온 값입니다. Oracle 이 공개한 다른 측정에서는 thread_pool_max_transactions_limit 을 512 로 두었습니다. 처리량이 정점에 도달하는 동시성은 장비 사양과 워크로드에 따라 달라지므로, 운영 환경에서 직접 측정해 보아야 합니다.
탐색 범위의 위쪽 끝은 운영 환경에서 처리해야 할 최대 동시 커넥션 수입니다. Max_used_connections 상태 변수로 확인할 수 있습니다. Oracle 은 이 값에서 시작해 상한을 낮춰 가며 처리량 변화를 보는 방법도 제시합니다.
thread_pool_size와 query_threads_per_group의 균형
thread_pool_size 는 그룹 수를, thread_pool_query_threads_per_group 은 그룹 하나에서 동시에 실행할 수 있는 쿼리 수를 정합니다. 두 값의 곱이 쿼리 처리에 쓸 수 있는 스레드 수이므로, 같은 총량을 만드는 조합이 여러 개 나옵니다.
케이스1: thread_pool_size 24 × per_group 4 = 96
케이스2: thread_pool_size 48 × per_group 2 = 96
총량은 같지만 그룹 수가 다르므로 커넥션이 나뉘는 모습이 달라집니다. 커넥션 1,000개를 받는다면 케이스1은 그룹당 약 42개, 케이스2는 약 21개를 맡습니다.
| 구성 | 장점 | 단점 |
| 케이스1 (size 낮게, per_group 높게) | 긴 쿼리가 그룹 전체를 점유할 가능성이 낮아집니다 | 그룹별 커넥션 폴링 비용이 증가합니다 |
| 케이스2 (size 높게, per_group 낮게) | 폴링 비용이 낮습니다 | 긴 쿼리 하나가 그룹을 점유하기 쉽습니다 |
폴링 비용은 그룹이 자기에게 배정된 커넥션을 감시하는 데 드는 비용입니다. 그룹 수가 적으면 그룹 하나가 맡는 커넥션이 많아지므로 이 비용이 올라갑니다.
10초짜리 쿼리가 섞이는 상황으로 보면, 케이스1 은 그런 쿼리가 4개 몰려야 그룹이 꽉 찹니다. 케이스2 는 2개면 찹니다. 대신 꽉 찼을 때 기다리는 커넥션은 케이스1 이 38개, 케이스2 가 19개입니다. 그룹을 잘게 나눌수록 더 쉽게 막히지만, 막혔을 때 영향을 받는 범위는 좁아집니다. 이 대기도 앞에서 본 것처럼 stall 로 판정될 때까지입니다.
per_group 을 2 미만으로 지정하는 것은 성능 향상에 기여하지 않는 경우가 대부분입니다. 26.7 기본값이 2 이므로 따로 지정하지 않아도 됩니다. MySQL 8.4 이하에서는 기본값이 1 이라 명시적으로 지정해야 합니다. per_group 을 1 로 둔 채 thread_pool_algorithm 을 1 로 지정하면 값을 올리는 것을 고려하라는 경고가 에러 로그에 남습니다.
Thread Pool 적용 판단
Thread Pool 을 도입할지 판단하려면 지금 환경이 이 기능이 효과를 내는 조건에 해당하는지부터 봐야 합니다. 커넥션이 많다는 이유만으로 켜면 기대한 결과가 안 나올 수 있습니다. 효과를 볼 수 있는 조건과, 켜도 그대로 남는 문제를 나누어 정리합니다.
효과를 기대할 수 있는 환경
아래 조건에 해당할수록 스레드 풀 도입에 따른 효과를 기대할 수 있습니다. 공통점은 커넥션 수가 CPU 가 동시에 처리할 수 있는 범위를 넘어선다는 것입니다. 이때 스레드를 커넥션 수만큼 만들면 CPU 는 실제 작업보다 스케줄링에 더 많은 시간을 쓰게 됩니다.
- 동시 connection이 매우 많음
- 동시에 실행되는 query가 많음
- 짧은 OLTP query가 많이 들어옴
- CPU scheduling/thread 관리 overhead가 커짐
- connection 수가 CPU가 처리할 수 있는 수준보다 훨씬 많음
애플리케이션 세 대가 각각 500개씩 커넥션을 맺는 구성이라면 이렇게 됩니다.
Application
 ├── App 1 : 500 connections
 ├── App 2 : 500 connections
 └── App 3 : 500 connections
             ↓
       1,500 connections
             ↓
         Thread Pool
             ↓
      제한된 worker threads
             ↓
             CPU
Thread Pool로 해결되지 않는 문제
반대로 Thread Pool 을 켜도 그대로 남는 문제들이 있습니다. 커넥션을 어떻게 처리하느냐와 무관한 영역이라 다른 방법으로 접근해야 합니다.
- Long-running query
- Disk I/O 대기
- Network 대기
- 잘못된 SQL/실행계획
- 인덱스 부족
- connection 자체가 많지 않은 환경
- CPU가 병목이 아닌 환경
Query A
 └── 30초 동안 Disk I/O 대기

Query B
 └── 20초 동안 Lock 대기

Query C
 └── 10초 동안 Network 대기
이런 경우 thread 개수만 조정한다고 근본적인 문제가 해결되지는 않습니다.
Lock 경합은 구분이 필요합니다. Max Transaction Limit은 동시 실행 트랜잭션 수를 제한하여 같은 시점에 점유되는 락의 수를 줄이므로 전체적인 경합 수준은 낮출 수 있습니다. 다만 특정 쿼리가 오래 잡고 있는 락 자체를 해소하지는 않습니다.
여기까지는 일반적인 판단 기준입니다. 직접 측정한 결과를 반영한 최종 판단 기준은 글 뒷부분에서 다시 정리합니다.
Thread Pool 활성화
MySQL Thread Pool 은 plugin 형태로 제공됩니다. 서버에 플러그인이 로드되어 있어야 동작하며, 로드되지 않은 상태에서는 관련 파라미터를 지정해도 적용되지 않습니다. 설치 여부를 확인하고, 로드한 뒤, 설정값을 넣는 순서로 진행합니다.
설치 여부 확인
현재 서버에 로드된 플러그인 목록을 확인합니다.
SHOW PLUGINS;
다음과 같이 INFORMATION_SCHEMA.PLUGINS 딕셔너리를 통해서도 확인할 수 있습니다.
SELECT PLUGIN_NAME, PLUGIN_STATUS
FROM INFORMATION_SCHEMA.PLUGINS
WHERE PLUGIN_NAME LIKE 'thread%';
+-------------+---------------+
| PLUGIN_NAME | PLUGIN_STATUS |
+-------------+---------------+
| thread_pool | ACTIVE        |
+-------------+---------------+
PLUGIN_STATUS 가 ACTIVE 면 로드된 상태입니다. 행이 조회되지 않으면 아직 로드되지 않은 것입니다.
플러그인 로드
thread_pool 플러그인은 dynamically installable 로 표시되어 있지 않습니다. 즉, 런타임 동적 설치가 되지 않습니다.
mysql> INSTALL PLUGIN thread_pool SONAME 'thread_pool.so';
ERROR 1721 (HY000): Plugin 'thread_pool' is marked as not dynamically installable.
You have to stop the server to install it.
따라서 plugin-load-add(또는 plugin-load, early-plugin-load) 옵션으로 서버 시작 시점에 로드하는 방식만 사용할 수 있습니다. my.cnf 에 추가하고 재시작합니다.
## 예시
[mysqld]
plugin-load-add=thread_pool.so
thread_pool_size=16
thread_pool_algorithm=1
plugin-load-add 이외 thread_pool_size와 thread_pool_algorithm 파라미터도 재시작이 필요한 파라미터 이므로 my.cnf 파일에 같이 설정을 하고 재시작을 하도록 합니다. 나중에 다시 변경하거나 추가하면 다시 재시작이 필요함으로 지금시점에서 같이 추가 하고 재시작을 진행합니다.
활성화 확인
재시작 후 Thread Pool 이 실제로 동작하고 있는지 확인합니다. thread_handling 변수를 보면 서버가 어느 커넥션 처리 모델을 쓰고 있는지 알 수 있습니다.
SHOW VARIABLES LIKE 'thread_handling';
조회 결과는 다음 두 가지 중 하나입니다.
| 값 | 상태 |
| loaded-dynamically | Thread Pool 사용 |
| one-thread-per-connection | 미사용. MySQL 기본값 |
관련 파라미터는 다음 쿼리로 확인합니다.
SHOW VARIABLES LIKE 'thread_pool%';
+----------------------------------------+-------+
| Variable_name                          | Value |
+----------------------------------------+-------+
| thread_pool_algorithm                  | 1     |
| thread_pool_connection_report_interval | 120   |
| thread_pool_dedicated_listeners        | OFF   |
| thread_pool_high_priority_connection   | 0     |
| thread_pool_longrun_trx_limit          | 2000  |
| thread_pool_max_active_query_threads   | 0     |
| thread_pool_max_transactions_limit     | 512   |
| thread_pool_max_unused_threads         | 32    |
| thread_pool_prio_kickup_timer          | 1000  |
| thread_pool_query_threads_per_group    | 2     |
| thread_pool_size                       | 16    |
| thread_pool_stall_limit                | 6     |
| thread_pool_transaction_delay          | 0     |
+----------------------------------------+-------+
여기 보이는 값들이 Thread Pool 의 동작을 결정합니다. 각 변수가 무엇을 하는지는 이어서 하나씩 정리합니다.
파라미터
이번 장에서는 thread pool과 관련된 파라미터에 설명입니다.
thread_pool_size
가장 중요한 Thread Pool 관련 설정 중 하나입니다.
SHOW VARIABLES LIKE 'thread_pool_size';
thread_pool_size는 thread group의 개수를 의미합니다. 기본값은 고정된 숫자가 아니라 vCPU/2를 최소 1, 최대 16 사이로 잘라낸 값(MIN(VCPU/2, 16))으로 정해집니다. GitHub 소스 코드(thread_pool_plugin.cc)에서도 std::clamp(vCPU/2, 1, 16)으로 동일하게 계산하는 것을 확인했습니다.
예를 들어 vCPU가 2개면 vCPU/2=1이라서 기본값이 1이 됩니다. 지정할 수 있는 범위는 1에서 512까지입니다.
값으로 0을 지정하면 Thread Pool이 꺼지는 것이 아니라 1로 시작합니다. Thread Pool을 끄려면 OFF를 지정해야 합니다.
thread_pool_size는 Dynamic 변수가 아닙니다. "--thread-pool-size" 시작 옵션으로만 설정할 수 있고, 값을 바꾸려면 서버 재시작이 필요합니다.
thread_pool_algorithm과 마찬가지로 plugin을 처음 로드할 때 재시작을 한 번만 하도록 같이 설정해두는 것이 좋습니다.
thread_pool_size = 16
16개로 설정을 하였다고 하면 다음의 이미지와 같이 16개의 thread group을 사용합니다.
            Thread Pool
                 │
┌────┬────┬────┬─┴─┬────┬────┐
G1   G2   G3   G4  ...   G15  G16
여기서 어려운점이나 생각해볼 부분은 적절한 Thread Pool 수입니다.
공식 문서(Thread Pool Tuning)의 권장 기준은 다음과 같습니다.
- InnoDB가 primary storage engine인 경우: 물리 코어(physical core) 수와 동일하게 설정 (최대 512)
- MyISAM이 primary storage engine인 경우: 4~8 사이의 낮은 값 권장
vCPU 수가 아니라 물리 코어 수 기준입니다. SMT(하이퍼스레딩)가 켜져 있으면 vCPU 수는 물리 코어 수의 2배입니다.
이번 테스트는 c6i.4xlarge 클래스로 진행하며 vCPU별 물리 코어 수는 다음과 같습니다.
vCPU 4 (물리 코어 2) -> thread_pool_size 시작점: 2
vCPU 8 (물리 코어 4) -> thread_pool_size 시작점: 4
vCPU 12(물리 코어 6) -> thread_pool_size 시작점: 6
vCPU 16(물리 코어 8) -> thread_pool_size 시작점: 8
c6i.4xlarge 는 CPU options 의 유효 CoreCount 가 2, 4, 6, 8 로 짝수만 허용됩니다. 그래서 vCPU 2 와 6 를 제외하고 진행합니다.
이 글에서는 위 값으로 시작해서 thread_pool_size를 바꿔가며 다음 항목들을 측정하고 비교해볼 예정입니다.
- TPS / QPS
- 평균 지연
- P95
- 최대 지연
- Threads_running
thread_pool_algorithm
공식 문서(MySQL 26.7, Thread Pool Operation)는 이 파라미터를 "The concurrency algorithm to use for scheduling"이라고 정의합니다. 즉 이름 그대로, Thread Pool이 statement/thread를 스케줄링할 때 사용하는 concurrency 알고리즘을 고르는 스위치입니다. 값은 0 또는 1이고, 기본값은 1입니다.
- 0 (low concurrency): conservative low-concurrency algorithm. 별도의 대기(listener) thread를 두지 않고, 하나의 thread가 이벤트 수신과 query 실행을 같은 루프 안에서 처리합니다. 처리할 게 없으면 거의 스케줄링되지 않는 "reserve group"으로 빠져서 대기합니다. thread 수는 많은데 실제 client는 적은 상황에서 불필요한 context switch를 줄이고 CPU 캐시 활용도를 높이는 데 초점이 맞춰져 있습니다.
- 1 (high concurrency, 기본값): aggressive high-concurrency algorithm. 대기 중인 query가 1개보다 많아지면(count_waiting_queries > 1) 다른 "hot"(이미 활동 중인) thread를 적극적으로 깨워서 병렬로 처리시킵니다. thread 수가 최적일 때는 성능이 더 좋지만, 동시 요청이 많을 때 처리량을 높이는 대신 thread를 깨우는 빈도가 늘어나 context switch 비용도 함께 증가하고, connection 수가 극단적으로 많아지면 오히려 성능이 떨어질 수 있습니다.
각 값의 실제 동작은 MySQL 서버 소스코드(GitHub, plugin/thread_pool/src/thread_pool.cc)의 low_concurrency_algorithm() / high_concurrency_algorithm() 함수로 확인할 수 있습니다.
thread_pool_algorithm의 기본값은 1(high concurrency)인데 thread_pool_query_threads_per_group을 1로 두면 그룹당 쿼리를 실행할 thread가 하나뿐이라 알고리즘이 다른 thread를 깨울 수 없습니다. 이 조합으로 서버를 시작하면 값을 올리는 것을 고려하라는 경고가 남습니다. 26.7의 per_group 기본값은 2라서 기본 설정에서는 해당되지 않고, 8.4 버전까지 기본값 1을 그대로 적용할 경우 에러 로그를 볼 수 있게 됩니다.
SHOW VARIABLES LIKE 'thread_pool_algorithm';
thread_pool_algorithm은 Dynamic 변수가 아닙니다. SET GLOBAL로 변경할 수 없고, 설정 파일에 값을 넣고 재시작해야 적용됩니다. thread_pool_size와 마찬가지로 plugin을 처음 로드할 때 재시작을 한 번만 하도록 같이 설정해두는 것이 좋습니다.
thread_pool_query_threads_per_group
중요한 Thread Pool 설정입니다. Dynamic 변수라 재시작 없이 SET GLOBAL로 변경할 수 있습니다.
기본값은 MySQL 8.4에서는 1이었으나, 9.7과 26.7 공식 문서 기준으로는 2로 변경되었습니다. 다만 두 버전 모두 문서 내 Properties 표는 기본값을 2라고 적어두고도, 바로 아래 설명 문단은 "The default value of 1 means..."처럼 여전히 1 기준 설명 문장을 그대로 남겨둔 상태입니다(공식 문서 자체의 불일치). 실제 서버에서도 기본값은 2로 확인됩니다.
예를 들어 이 값을 1로 설정하면 group 하나에서 한 번에 query 하나만 실행됩니다.
SHOW VARIABLES LIKE 'thread_pool_query_threads_per_group';
값을 1로 설정하면 Long-running query가 있을 때 다음 예시처럼 다른 query가 기다릴 수 있습니다.
Group 1  (thread_pool_query_threads_per_group = 1)

Query A ─────────────── 10 sec 실행
Query B ─ 대기 (stall_limit 경과 후 실행)
Query C ─ 대기
Query D ─ 대기
다만 이 대기가 A가 끝날 때까지 이어지지는 않습니다. A가 thread_pool_stall_limit을 넘겨서 실행되면 그룹은 A를 stalled로 보고 동시 실행 상한을 하나 늘립니다. 그래서 B가 실행에 들어갑니다. 이 동작은 다음에 나오는 thread_pool_stall_limit에서 이어서 설명합니다.
기본값 2에서는 group 하나에서 두 개까지 동시에 실행됩니다. 긴 query 두 개가 같은 group을 채우면 그 뒤의 query는 앞의 query가 stalled로 판정될 때까지 기다립니다. 긴 query가 자주 섞이는 환경이라면 이 대기가 반복해서 쌓이기 때문에 thread_pool_query_threads_per_group을 3 이상으로 올려보는 것을 고려할 수 있습니다.
공식 문서도 long-running transaction 때문에 응답이 느려지면 값을 올리는 것을 검토하라고 적고 있습니다. 다만 값을 올릴수록 Thread Pool의 동시 실행 제한 효과는 약해집니다.
thread_pool_stall_limit
실행 중인 query가 이 기준 시간을 넘기면 "stalled"로 판정하고, 그 group에 다른 query를 처리할 worker thread를 하나 더 투입하는 규칙이 있습니다. thread_pool_stall_limit은 그 기준 시간을 정하는 값입니다.
- 값이 짧으면: query가 조금만 오래 걸려도 금방 stalled로 판정되어 thread가 빨리 추가됩니다. 대기 시간은 짧아지지만, 사실 별로 안 느린 query까지 stalled로 오판해서 불필요하게 thread가 자주 늘어날 수 있습니다.
- 값이 길면: 웬만큼 오래 걸려야 stalled로 판정되므로 thread가 잘 늘어나지 않습니다. 불필요한 thread 증가는 적지만, 실제로 긴 query 뒤에서 짧은 query가 오래 대기할 수 있습니다.
값은 10ms 단위로 설정됩니다. 기본값은 6이며, 6 × 10ms = 60ms가 stall 기준 시간이 됩니다.(기본값)
최대값은 600(=6초)이며, Dynamic 변수라 재시작 없이 SET GLOBAL로 바로 바꿀 수 있습니다. 예를 들어 "thread_pool_stall_limit = 10"으로 설정하면 10 × 10ms = 100ms가 stall 기준이 됩니다.
SHOW VARIABLES LIKE 'thread_pool_stall_limit';
query 하나가 stalled로 판정되고 worker가 추가되기까지의 순서입니다.
Group 1

Query A
  ↓
실행 시작
  ↓
설정된 stall 기준 이상 장시간 실행
  ↓
STALLED
  ↓
다른 query를 실행할 수 있도록 worker 추가/스케줄링
평소 쿼리가 대부분 60ms 안에 끝난다면 기본 설정값을 그대로 유지합니다. 그보다 오래 걸리는 쿼리가 많다면 stall 판정이 자주 나므로 값을 올려서 확인해보도록 합니다.
thread_pool_max_transactions_limit
Thread Pool plugin이 동시에 처리할 수 있는 transaction 수의 상한을 서버 전체 기준으로 정하는 설정입니다. 상한을 정해두면 하나의 thread가 transaction이 commit될 때까지 그 transaction에 묶여 있게 되고, 이렇게 해서 높은 동시성 상황에서 처리량을 안정시키는 효과를 냅니다.
9.7버전부터 기본값은 고정된 숫자가 아니라 MIN(32 × thread_pool_size, 512) 공식으로 계산됩니다. thread_pool_size가 클수록 기본 상한도 같이 커지지만 512를 넘지는 않습니다. 최솟값은 0, 최댓값은 1,000,000입니다.
값을 0으로 설정하면 상한이 없다는 뜻입니다. 26.7버전 메뉴얼에는 Dynamic 변수이긴 하지만 0과 0이 아닌 값 사이는 런타임 중에 전환할 수 없음으로 기재되어있지만 26.7 버전에서 동작 테스트 런타임 중에서 0->다른값, 또는 다른값 -> 0 으로 변경이 가능한 것을 확인하였습니다.
SHOW VARIABLES LIKE 'thread_pool_max_transactions_limit';
Thread Pool Tuning 문서는 이 값의 초기 설정으로 물리 코어 수 × 32를 권장합니다. thread_pool_size를 물리 코어 수와 같게 설정했다면 기본값 공식과 같은 값이 나옵니다.
다만 기본값에는 512 상한이 붙어 있어서, 물리 코어가 16개를 넘으면 권장값 쪽이 더 큽니다. 이 경우 기본값으로 두면 512가 되므로 직접 지정해야 합니다. 이후 실제 workload를 관찰하면서 값을 낮춰 조정하는 방식을 권장하며, 합리적인 상한선은 예상되는 최대 동시 connection 수(Max_used_connections status 변수를 참고)입니다.
thread_pool_longrun_trx_limit
thread_pool_longrun_trx_limit은 실행 중인 transaction을 Long Run Query로 볼지 가르는 기준 시간(ms)입니다. thread_pool_max_transactions_limit으로 상한이 걸려 있을 때, 그 상한을 푸는 조건이 됩니다.
어느 그룹에서 자기 몫의 transaction 자리를 오래 걸리는 batch 작업이 전부 차지하고 있으면, 그 그룹에 새로 들어온 transaction은 앞의 작업 하나가 끝날 때까지 시작하지 못합니다. 사용자 입장에서는 이유를 알 수 없이 쿼리가 멈춘 것처럼 보입니다. 자리를 차지한 작업들이 전부 이 기준 시간을 넘겨서 실행 중이면, 그 그룹에 한해 상한을 풀고 새 transaction을 받습니다.
SHOW VARIABLES LIKE 'thread_pool_longrun_trx_limit';
기본값은 2,000ms(2초)입니다. GitHub 소스 코드(thread_pool.h의 DEF_LONGRUN_TRX_LIMIT = 2000)로도 같은 값이 확인됩니다. 최솟값은 10ms, 최댓값은 86,400,000ms(24시간)입니다. 공식 문서 Properties 표에는 최댓값이 60×60×24로 적혀 있는데, 단위가 ms이므로 86,400,000이 맞습니다. Dynamic 변수라 재시작 없이 SET GLOBAL로 바꿀 수 있습니다.
오래 걸리던 transaction들이 끝나서 그 그룹의 긴 transaction 수가 그룹 몫의 절반 밑으로 떨어지면, MySQL은 다시 제한을 겁니다. 다만 그 상태가 일정 시간(기본값 기준 30초) 유지된 뒤에야 다시 걸립니다. transaction 수가 경계값 근처에서 오르내릴 때마다 제한이 반복적으로 켜졌다 꺼졌다 하지 않도록 하는 장치입니다.
thread_pool_max_active_query_threads
group당 동시에 "active(실행 중)"인 query thread 수의 상한을 정하는 설정입니다. 값이 0이면 무제한이라서, 사용 가능한 thread를 필요한 만큼 다 씁니다. thread_pool_query_threads_per_group이 group에 존재할 수 있는 query thread의 총 개수를 정하는 것과 달리, 이 값은 그중 동시에 "실행 중"일 수 있는 thread 수만 따로 제한합니다.
기본값은 0이고, 최솟값 0, 최댓값 512입니다. GitHub 소스 코드(thread_pool.h의 DEF_MAX_ACTIVE_QUERY_THREADS = 0, TP_MAX_MAX_ACTIVE_QUERY_THREADS = 512)로도 공식 문서와 정확히 일치하는 것을 확인했습니다.
SHOW VARIABLES LIKE 'thread_pool_max_active_query_threads';
값이 0(기본값)이면 앞에서 본 stall 판정 방식이 그대로 적용되어 group당 active thread 수를 관리합니다. 0보다 큰 값을 넣으면 그 값이 group당 active thread 수의 상한이 됩니다.
다만 이 상한은 thread_pool_max_transactions_limit이 0일 때만 적용됩니다. 상한이 걸려 있으면 transaction 상한 판정이 먼저 이루어지고 이 값은 쓰이지 않습니다. 26.7버전의 max_transactions_limit 기본값은 0이 아니므로, 기본 설정 그대로라면 이 값을 넣어도 동작하지 않습니다.
thread_pool_dedicated_listeners
thread pool의 각 group마다 listener 역할을 하는 thread가 1개씩 있고, 이 역할은 특정 thread에 고정되지 않고 query 실행에 쓰이는 thread가 돌아가면서 맡습니다.
thread_pool_max_transactions_limit으로 group당 동시 transaction 수를 제한해두면, 스레드가 커밋될 때까지 transaction에 묶이기 때문에 listener 역할을 맡을 스레드가 부족해질 수 있습니다.
thread_pool_dedicated_listeners를 ON으로 두면 group마다 statement 수신만 맡는 thread를 하나 더 둡니다. 이 thread는 query를 실행하지 않고 listener 역할만 하기 때문에, 다른 thread가 transaction에 묶여 있어도 새 statement를 받는 쪽은 막히지 않습니다.
SHOW VARIABLES LIKE 'thread_pool_dedicated_listeners';
기본값은 OFF입니다. Dynamic 변수가 아니라서(PLUGIN_VAR_READONLY) 서버 시작 시 옵션으로만 설정할 수 있고, 값을 바꾸려면 재시작이 필요합니다. thread_pool_size, thread_pool_algorithm과 마찬가지로 plugin을 처음 로드할 때 같이 설정해두는 것이 좋습니다.
이 값은 thread_pool_max_transactions_limit을 쓸 때만 의미가 있습니다. max_transactions_limit이 0(제한 없음)인 상태에서 이 값을 ON으로 설정해 서버를 시작하면, 서버가 이 값을 자동으로 OFF로 되돌리고 경고 로그를 남깁니다.
thread_pool_max_unused_threads
thread_pool_max_unused_threads는 group마다 잠들어 있을 수 있는 thread 수의 상한입니다. 잠든 thread도 메모리를 계속 차지하기 때문에, 트래픽이 몰렸다 빠지는 일이 반복되면 일하지 않는 thread가 쌓일 수 있습니다. 상한에 도달한 뒤에 또 다른 thread가 잠들려고 하면, 그 thread는 잠들지 않고 종료됩니다.
예를 들어 어떤 group에서 긴 쿼리가 계속 stall로 판정되면서 thread가 50개까지 늘어났다가, 쿼리가 다 끝나서 이 50개 thread가 한꺼번에 할 일이 없어졌다고 하면, 기본값(32) 기준으로 32개는 그대로 sleeping 상태로 남고 나머지 18개는 종료됩니다. group이 16개(thread_pool_size=16)라면, 시스템 전체로는 최대 16 × 32 = 512개까지 sleeping thread가 메모리를 차지할 수 있다는 뜻입니다.
Dynamic 변수라 재시작 없이 SET GLOBAL로 바꿀 수 있습니다.
SHOW VARIABLES LIKE 'thread_pool_max_unused_threads';
기본값은 32입니다. 공식 문서의 변수 속성 표는 32로 적고 있는데 바로 아래 설명 문단은 "0이 기본값"이라고 서술해서 서로 다릅니다. GitHub 소스 코드(thread_pool.h의 DEF_MAX_UNUSED_THREADS = 32)로 32가 맞다는 걸 확인했습니다. 값을 0으로 설정하면 잠든 thread 수에 제한을 두지 않습니다. 최솟값은 0, 최댓값은 4096입니다.
Thread Pool 테스트 및 결과
테스트 환경
Thread Pool을 테스트 하기 위한 환경은 다음과 같습니다.
| 항목 | 내용 |
| DB | MySQL 26.7.0 Community. Thread Pool 플러그인이 포함된 첫 Community 버전입니다. |
| 서버 | AWS EC2 c6i.4xlarge (16 vCPU, 32 GiB). CPU options 로 활성 vCPU 를 4 ~ 16 으로 조정합니다. |
| 측정 도구 | sysbench, MySQL tarball 의 클라이언트 라이브러리로 소스 빌드했습니다. |
| 워크로드 | oltp_read_only. 테이블 16개에 각 100만 행, rand-type 은 uniform 입니다. |
| 데이터 | 약 3.5GB. innodb_buffer_pool_size 8G 안에 전부 올라가 디스크 I/O 병목이 없습니다 |
테스트 매트릭스
CPU 수를 바꿔가며 각 구간에서 Thread Pool ON 과 OFF 를 모두 측정하였습니다. EC2 는 인스턴스를 새로 만들지 않고 CPU options 의 CoreCount 와 ThreadsPerCore 로 활성 vCPU 수를 조정할 수 있습니다.
c6i.4xlarge 에서 지정할 수 있는 CoreCount 는 2, 4, 6, 8 뿐이라 vCPU 2 와 6 은 구성할 수 없습니다. ThreadsPerCore 는 전 구간 2 로 고정하고 CoreCount 만 바꿉니다. 물리 코어 수는 항상 vCPU 의 절반이 됩니다.
| vCPU | CoreCount | ThreadPerCore | Thread_pool_size | Thread Pool 활성화 여부 |
| 4 | 2 | 2 | 2 / 4 | ON / OFF |
| 8 | 4 | 2 | 4/ 8 | ON / OFF |
| 12 | 6 | 2 | 6 / 12 | ON / OFF |
| 16 | 8 | 2 | 8 / 16 | ON / OFF |
thread_pool_size 는 구간마다 두 값으로 측정합니다. 한 번은 CoreCount 값만큼 설정하고, 한 번은 vCPU 값으로 설정하여 테스트하였습니다. 예를 들어 vCPU 8 구간이면 thread_pool_size 를 4 로 두고 한 번, 8 로 두고 한 번 측정합니다.
권장값은 물리 코어 수, 즉 CoreCount 입니다. 다만 SMT 가 켜져 있어 논리 코어가 그 두 배이므로, 그룹 수를 vCPU 만큼으로 설정하여 추가적인 성능 테스트를 진행하였습니다.
여기서 말하는 concurrency 는 sysbench 의 --threads 값입니다. sysbench 는 worker 수만큼 실제로 쿼리를 계속 수행요청 하므로 Threads_connected 와 Threads_running 이 거의 같아집니다. 그래서 --threads 값이 곧 동시 실행량이 됩니다.
sysbench의 threads 128, 256, 512, 1024 네 단계를 사용했고, 같은 네 단계를 Thread Pool OFF 와 ON 에서 각각 측정해 비교합니다.
같은 vCPU 안에서 Thread Pool 기능 ON 과 OFF 를 연속으로 측정하면 인스턴스 재기동 횟수를 줄일 수 있습니다. ON 과 OFF 전환은 my.cnf 를 수정하고 mysqld 를 재시작하며, 활성 vCPU 변경은 서버 인스턴스를 중지했다 다시 시작합니다.
재시작하면 buffer pool 이 비워집니다. 그대로 측정하면 쿼리마다 디스크를 읽으면서 EBS IOPS 한계에 먼저 걸려 결과가 왜곡됩니다. 그래서 재시작할 때마다 warm-up 을 먼저 수행하여 데이터를 buffer pool 에 올린 뒤 측정합니다.
MySQL과 Sysbench
MySQL 26.7버전에서 Thread Pool Plugin을 Community Edition에 처음 포함시킨 버전입니다. 그 이전 버전의 Community Edition에는 Thread Pool 자체가 없었고 Enterprise Edition에서만 제공됐습니다("MySQL 26.7 makes the Thread Pool Plugin available in MySQL Community Server")
- MySQL 26.7 이전 버전 : Community Edition에 Thread Pool 없음 (Enterprise 전용)
- MySQL 26.7 이후 버전: Community Edition에도 Thread Pool Plugin 포함
글 작성 시점 기준으로 AWS 클라우드 기준으로 26.7버전이 RDS에서 미지원 및 Thread Pool 플러그인을 지원하지 않으므로 EC2에 MySQL 26.7 Community Edition을 직접 설치해서 진행하였습니다.
sysbench 는 MySQL 성능 측정에 널리 쓰이는 오픈소스 벤치마크 도구입니다. 지정한 수의 worker 스레드가 각자 접속을 열고 정해진 쿼리를 반복 실행하면서 처리량과 응답 시간을 기록합니다. 측정에 쓸 테이블을 만들고 데이터를 채우는 prepare, 실제 측정인 run, 데이터를 지우는 cleanup 으로 나뉘어 동작합니다.
쿼리 구성은 Lua 스크립트로 정의되며 기본으로 몇 가지가 들어 있습니다. 이번에는 읽기 전용인 oltp_read_only 를 사용합니다.
sysbench 설치는 크게 패키지를 통한 설치와 소스 빌드 방식이 있으며 이번 테스트에서는 소스 빌드를 통해 설치하였습니다.
sysbench에서 사용할 테이블은 총 16개로 생성하였으며 테이블 사이즈 합쳐서 약 3.5GB 정도 입니다.
파라미터 설정
MySQL 설치 및 구성이후 다음과 같이 파라미터를 설정합니다.
[mysqld]
innodb_buffer_pool_size = 8G # 시스템에 따라 달라짐
max_connections         = 4000
max_connect_errors      = 1000
max_prepared_stmt_count = 1048576

# Thread Pool ON 구간에서만 사용합니다
plugin-load-add                    = thread_pool.so
thread_pool_size                   = 4    # 측정 조건에 따라 변경
thread_pool_max_transactions_limit = 512  # 전 구간 고정
thread_pool_size 는 my.cnf 에 직접 명시하고, vCPU 를 바꿀 때마다 함께 고칩니다. 지정하지 않으면 MIN(vCPU/2, 16) 으로 자동 계산되어 의도한 값과 달라집니다. SMT 2 환경에서 이 기본값은 물리 코어 수와 같습니다. 측정은 구간마다 물리 코어 수와 활성 vCPU 수 두 값으로 하므로, 회차에 맞춰 값을 바꿔 넣습니다.
max_connections 가 4000 이므로 concurrency 를 1024 까지 올려도 접속 한도에 걸리지 않습니다. 한도에 걸리면 sysbench 가 접속 오류를 내기 때문에, 측정하려는 최대 concurrency 보다 충분히 크게 설정합니다.
thread_pool_max_transactions_limit
전 구간에서 512 로 고정하여 진행하였습니다. 이 값은 thread group 이 동시에 처리할 수 있는 트랜잭션 수의 상한입니다. 기본값은 MIN(32 × thread_pool_size, 512) 로 계산되므로 thread_pool_size 를 바꾸면 상한값도 같이 바뀝니다.
| thread_pool_size | 기본 상한 |
| 4 | 128 |
| 6 | 192 |
| 8 | 256 |
| 12 | 384 |
| 16 | 512 |
이번 테스트는 size 를 두 값으로 바꿔가며 비교하므로 이 부분이 문제가 됩니다. size 4 는 상한 128, size 12 는 384 가 되어 두 회차의 조건이 size 말고도 달라집니다. 그래서 상한을 512 로 지정해 전 구간 동일하게 두었습니다.
max_prepared_stmt_count
서버 전체에서 동시에 유지할 수 있는 prepared statement 개수의 상한입니다. 세션별이 아니라 서버 합계이며 기본값은 16382 입니다.
sysbench 의 oltp 스크립트는 스레드마다 prepared statement 를 여러 개 생성합니다. 스레드 수가 늘면 그만큼 누적되고, 한도를 넘으면 아래 오류와 함께 sysbench 프로세스가 비정상 종료되는 경우가 있습니다. 기본값 그대로 두면 concurrency 256 이상에서 측정이 되지 않습니다.
FATAL: mysql_stmt_prepare() failed
FATAL: MySQL error: 1461 "Can't create more than max_prepared_stmt_count statements (current value: 16382)"
FATAL: `thread_init' function failed: oltp_common.lua:284: SQL API error
FATAL: Thread initialization failed!
double free or corruption (fasttop)
Aborted (core dumped)
다음과 같이 파라미터 변경 및 값을 확인할 수 있습니다.
-- 파라미터 설정
SET GLOBAL max_prepared_stmt_count = 1048576;

-- 파라미터값 확인
SHOW VARIABLES LIKE 'max_prepared_stmt_count';
SHOW GLOBAL STATUS LIKE 'Prepared_stmt_count';
동적 변수로 변경이 가능하지만 CPU 변경 등에 따라서 MySQL이 계속적으로 재시작됨으로 my.cnf 에도 파라미터를 설정해야 합니다. 파일에 없으면 재시작한 뒤 기본값 16382 로 돌아가 같은 오류를 다시 만나게 됩니다.
테스트 결과
측정은 vCPU 4 / 8 / 12 / 16, Thread Pool OFF 와 ON, thread_pool_size 두 값, concurrency 128 / 256 / 512 / 1024 조합으로 진행했습니다. thread_pool_max_transactions_limit 은 전 구간 512 로 수행하였습니다.
테스트 전체 결과 요약
처리량 (QPS)
표의 128 / 256 / 512 / 1024 는 concurrency 이고, 조건 열의 size 는 thread_pool_size 입니다. 같은 vCPU 구간의 세 조건 중 가장 높은 값을 굵게 표시했습니다.
| 구간 | 조건 | 128 | 256 | 512 | 1024 |
|---|---|---|---|---|---|
| vCPU 4 | OFF | 31,414 | 30,139 | 27,771 | 25,455 |
| vCPU 4 | ON size 2 | 30,435 | 28,848 | 26,932 | 25,556 |
| vCPU 4 | ON size 4 | 30,357 | 28,850 | 27,095 | 25,508 |
| vCPU 8 | OFF | 64,353 | 60,404 | 54,895 | 51,193 |
| vCPU 8 | ON size 4 | 62,891 | 58,772 | 53,787 | 51,412 |
| vCPU 8 | ON size 8 | 62,796 | 58,992 | 54,613 | 51,388 |
| vCPU 12 | OFF | 98,757 | 92,963 | 84,655 | 78,196 |
| vCPU 12 | ON size 6 | 95,328 | 90,625 | 83,729 | 79,181 |
| vCPU 12 | ON size 12 | 94,831 | 90,107 | 83,932 | 79,034 |
| vCPU 16 | OFF | 134,495 | 130,132 | 119,155 | 108,830 |
| vCPU 16 | ON size 8 | 128,522 | 124,359 | 115,746 | 110,932 |
| vCPU 16 | ON size 16 | 129,985 | 125,693 | 116,507 | 109,811 |
최대 지연 (ms)
측정 구간에서 가장 오래 걸린 쿼리 한 건의 응답 시간이며, 값이 낮을수록 좋습니다. 같은 vCPU 구간의 세 조건 중 가장 낮은 값을 굵게 표시했습니다.
| 구간 | 조건 | 128 | 256 | 512 | 1024 |
|---|---|---|---|---|---|
| vCPU 4 | OFF | 702.54 | 1,880.01 | 3,243.67 | 4,261.27 |
| vCPU 4 | ON size 2 | 340.85 | 1,107.22 | 1,160.95 | 1,704.39 |
| vCPU 4 | ON size 4 | 434.55 | 963.69 | 1,356.68 | 1,701.77 |
| vCPU 8 | OFF | 204.46 | 548.81 | 1,705.02 | 2,480.67 |
| vCPU 8 | ON size 4 | 172.37 | 495.30 | 766.58 | 1,252.86 |
| vCPU 8 | ON size 8 | 242.66 | 396.40 | 1,271.63 | 1,421.44 |
| vCPU 12 | OFF | 90.17 | 229.51 | 466.73 | 1,121.69 |
| vCPU 12 | ON size 6 | 108.72 | 239.82 | 704.88 | 639.55 |
| vCPU 12 | ON size 12 | 107.56 | 269.54 | 527.29 | 720.44 |
| vCPU 16 | OFF | 74.81 | 189.23 | 389.54 | 1,075.70 |
| vCPU 16 | ON size 8 | 79.50 | 145.22 | 544.86 | 496.70 |
| vCPU 16 | ON size 16 | 73.60 | 188.28 | 426.56 | 841.12 |
테스트 세부 내역
처리량(QPS) - 실질적 차이 없음
처리량(QPS) 부터 확인하도록 하겠습니다. 4개 구간의 concurrency 별로 그래프는 다음과 같습니다.
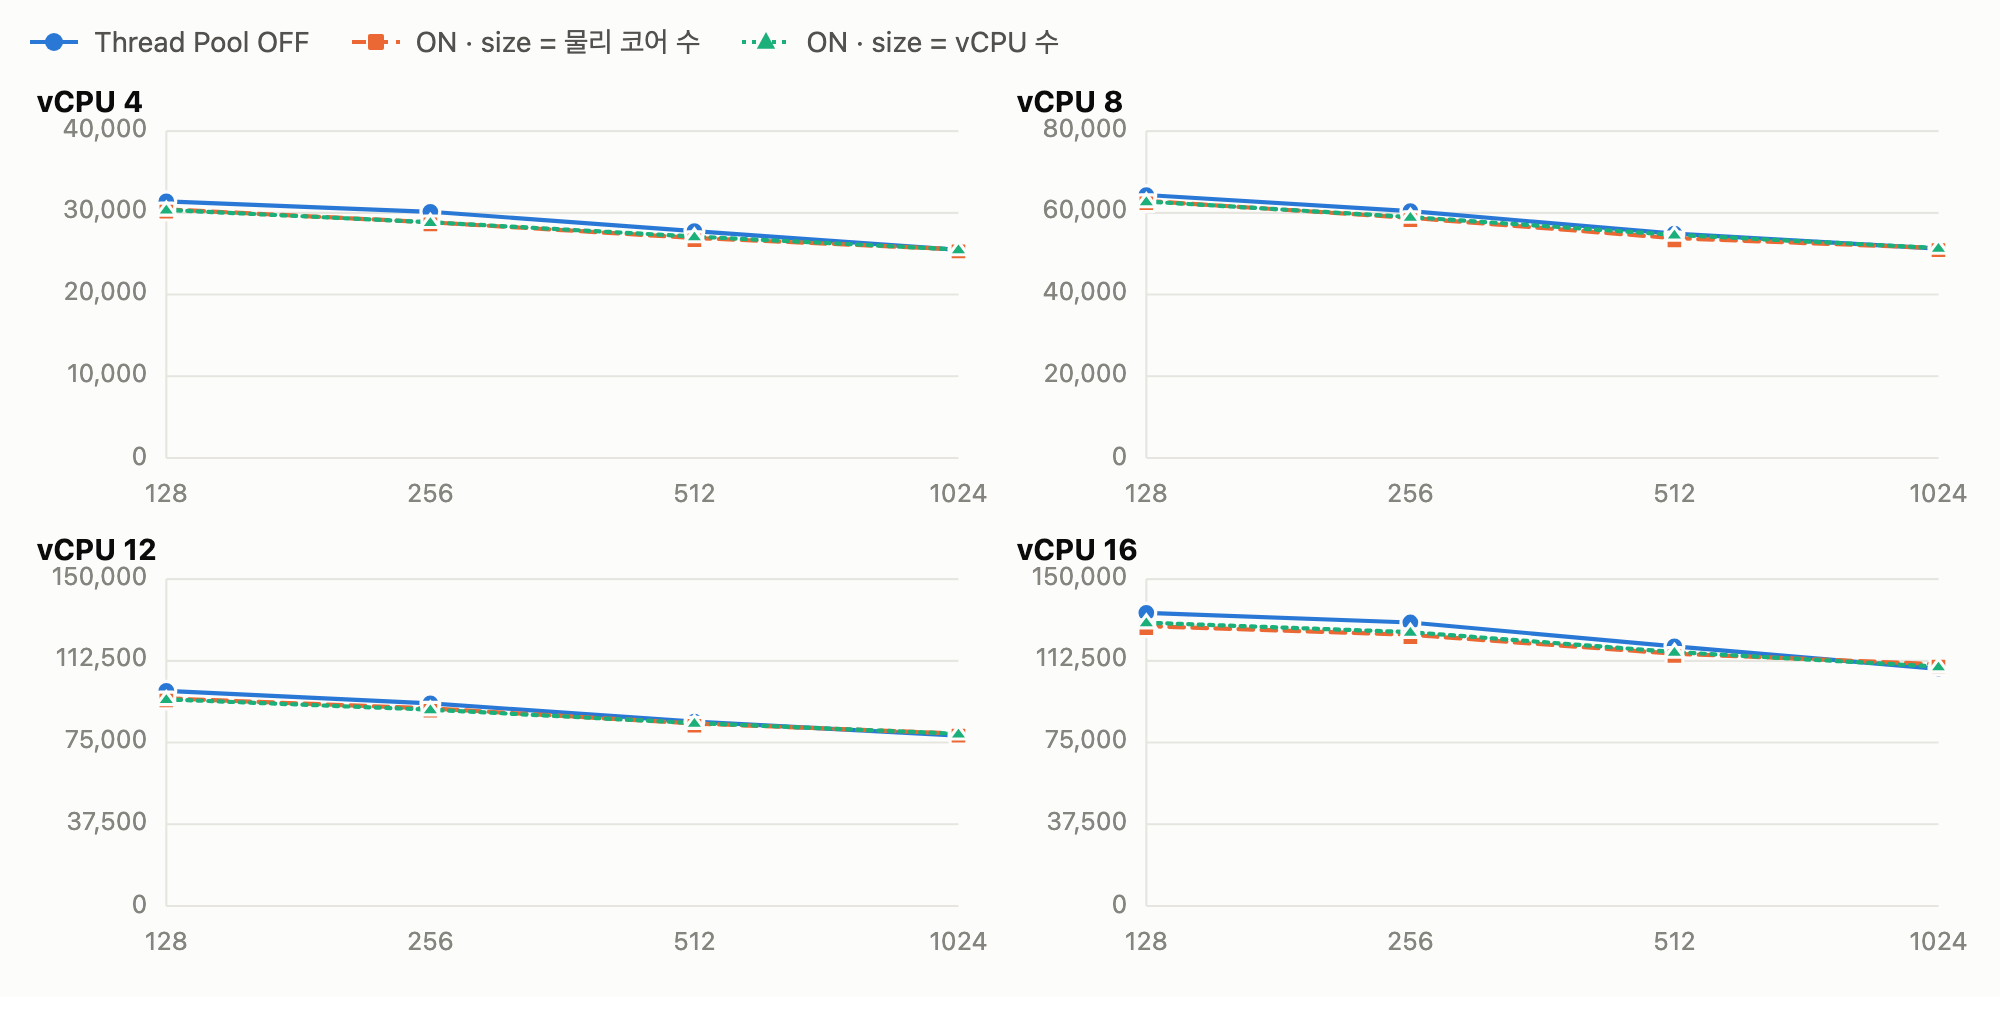
4개 구간 모두 세 선이 거의 붙어 있습니다. 다음 결과는 concurrency 1024 구간에서 OFF 와 ON 을 비교한 값이며, ON 은 앞의 결과표에서 thread_pool_size 를 CoreCount 로 둔 경우와 vCPU 로 둔 경우 중 더 높게 나온 쪽입니다.
| 구간 | OFF | 최적 ON | 차이 |
|---|---|---|---|
| vCPU 4 | 25,455 | 25,556 | +0.4% |
| vCPU 8 | 51,193 | 51,412 | +0.4% |
| vCPU 12 | 78,196 | 79,181 | +1.3% |
| vCPU 16 | 108,830 | 110,932 | +1.9% |
4개 구간 전부 2% 이내입니다. 측정 편차가 0.92% 이므로 유의미한 차이라고 보기 어렵습니다. concurrency 512 이하에서는 오히려 OFF 가 앞섭니다.
다음은 concurrency 128 구간의 차이입니다.
| 구간 | OFF 대비 ON |
|---|---|
| vCPU 4 | -3.1% |
| vCPU 8 | -2.3% |
| vCPU 12 | -3.5% |
| vCPU 16 | -4.4% |
겹쳐 보이던 구간을 OFF 대비 차이로 다시 그리면 이렇습니다. 회색 띠가 측정 편차 범위입니다.
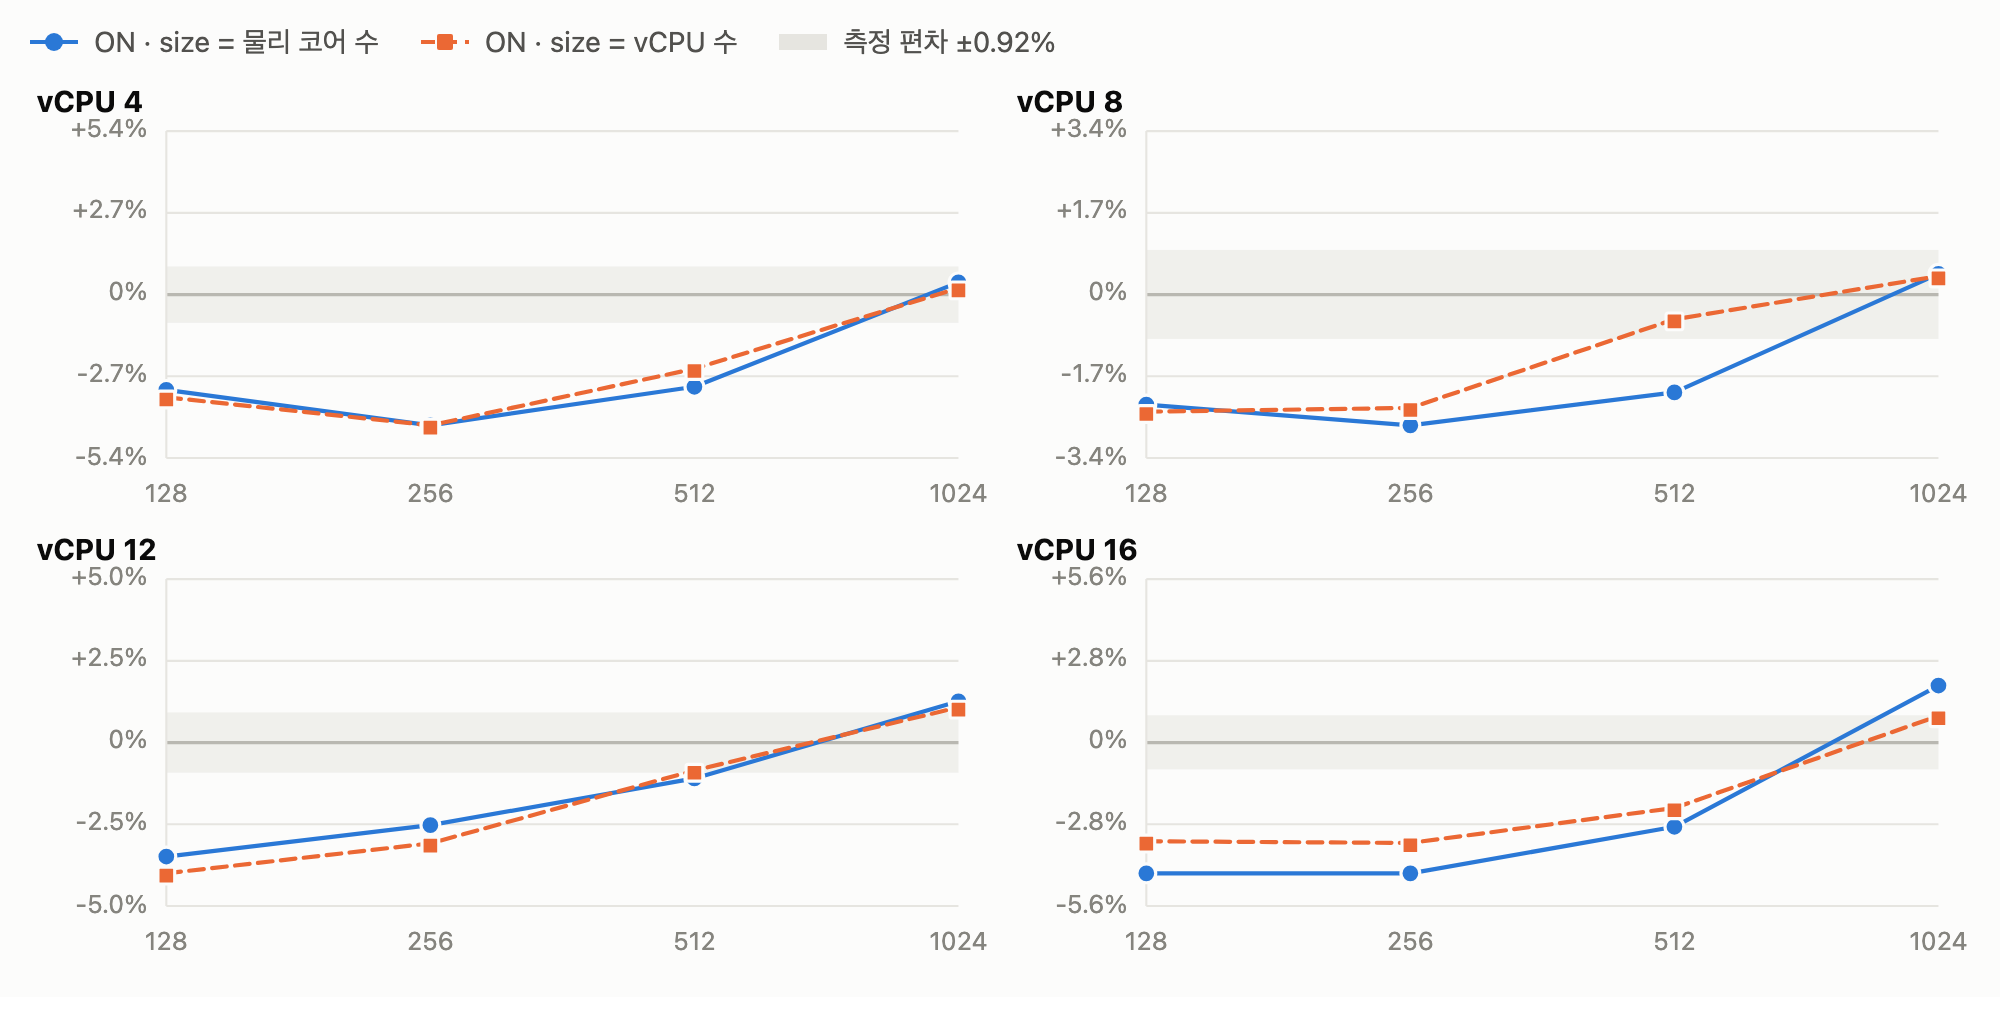
Thread Pool ON 이 OFF 보다 높게 나온 구간은 concurrency 1024 한 곳 뿐이며, 그 차이도 측정 편차 범위 안입니다.
최대 지연 - 개선됨
이번에는 최대 지연을 확인하겠습니다. 측정 구간에서 가장 오래 걸린 쿼리 한 건의 응답 시간이며, 값이 낮을수록 좋습니다.
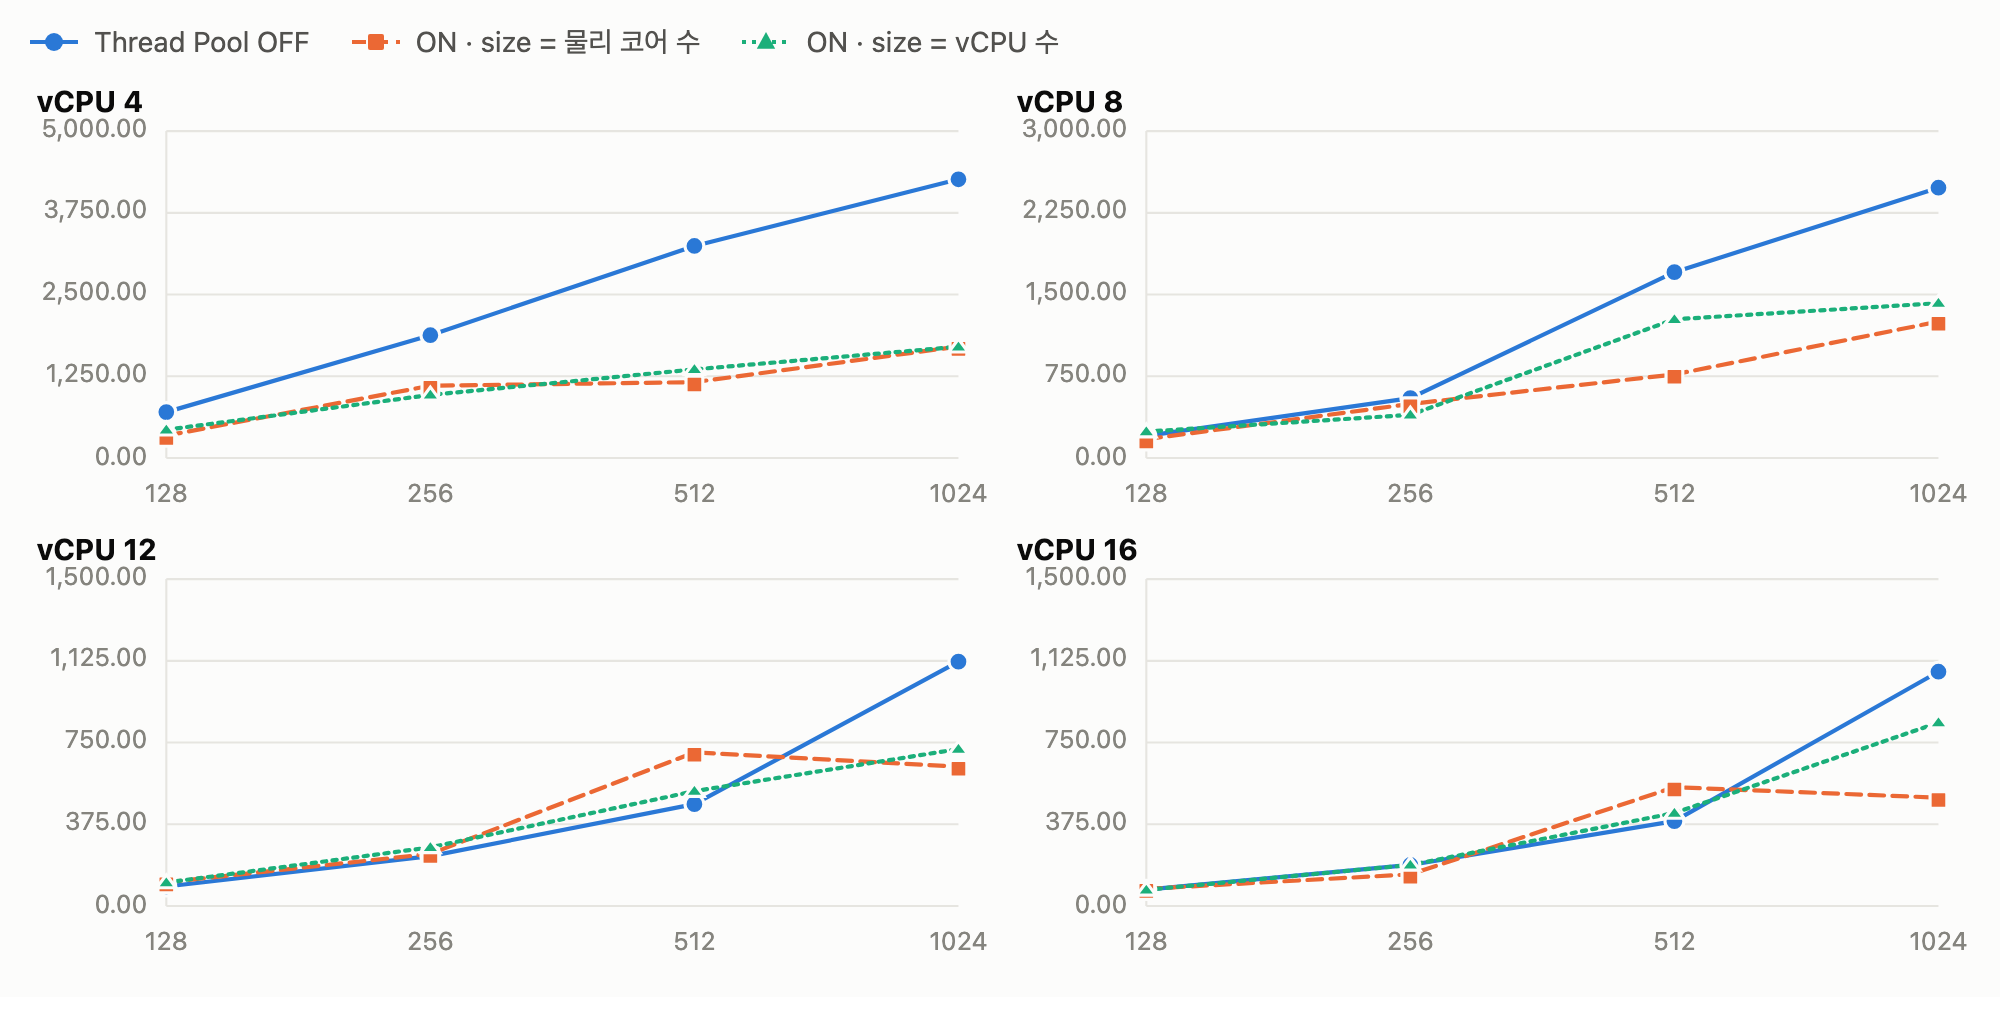
처리량과 달리 OFF 와 ON 의 차이가 분명하게 나타납니다. concurrency 1024 구간의 최대 지연은 다음과 같습니다. ON 은 thread_pool_size 두 값 중 더 낮은 쪽을 기재하였습니다.
| 구간 | OFF | 최적 ON | OFF 대비 |
|---|---|---|---|
| vCPU 4 | 4,261.27ms | 1,701.77ms | 40% |
| vCPU 8 | 2,480.67ms | 1,252.86ms | 50% |
| vCPU 12 | 1,121.69ms | 639.55ms | 57% |
| vCPU 16 | 1,075.70ms | 496.70ms | 46% |
4개 구간 모두 Thread Pool ON 의 최대 지연이 OFF 의 40 ~ 57% 수준으로 낮습니다. 처리량은 1% 안팎의 차이였는데 최대 지연은 절반 가까이 줄었습니다.
최대 지연과 달리 평균 지연은 거의 같습니다. 같은 구간의 평균 지연입니다.
| 구간 | OFF | 최적 ON | OFF 대비 |
|---|---|---|---|
| vCPU 4 | 638.42ms | 635.70ms | -0.4% |
| vCPU 8 | 318.44ms | 316.42ms | -0.6% |
| vCPU 12 | 208.60ms | 205.81ms | -1.3% |
| vCPU 16 | 149.97ms | 147.01ms | -2.0% |
평균 지연은 2% 이내 차이인데 최대 지연은 OFF 의 40 ~ 57% 수준입니다.
평균 지연은 측정 구간에서 실행된 전체 쿼리의 평균이고, 최대 지연은 그중 가장 오래 걸린 한 건입니다. 두 값이 다르게 움직였다는 것은 Thread Pool 적용으로 달라진 쿼리가 전체가 아니라 일부였다는 뜻입니다.
vCPU 12 의 concurrency 1024 구간이 그렇습니다. 평균 지연은 208.60ms 에서 205.81ms 로 1.3% 차이인데, 최대 지연은 1,121.69ms 에서 639.55ms 로 482.14ms 줄었습니다. 대부분의 쿼리는 200ms 안팎에서 끝났고 Thread Pool 적용 여부와 무관했습니다. 달라진 것은 1초 넘게 걸리던 쿼리 쪽입니다.
다만 모든 구간에서 Thread Pool ON 이 유리한 것은 아닙니다. 앞의 최대 지연 결과표에서 OFF 와 최적 ON 중 더 낮은 쪽을 표시하면 이렇습니다.
| 구간 | 128 | 256 | 512 | 1024 |
|---|---|---|---|---|
| vCPU 4 | ON | ON | ON | ON |
| vCPU 8 | ON | ON | ON | ON |
| vCPU 12 | OFF | OFF | OFF | ON |
| vCPU 16 | ON | ON | OFF | ON |
vCPU 4 와 8 은 전 구간에서 ON 이 낮습니다(값은 낮을수록 좋습니다). vCPU 12 와 16 은 중간 구간에서 OFF 가 낮게 나오기도 하지만 concurrency 1024 에서는 모두 ON 이 낮습니다. vCPU 가 많으면 커넥션당 스레드를 그대로 두어도 한동안 감당이 되고, 동시 실행이 많아질수록 Thread Pool ON 이 더 낮게 나왔습니다.
Thread Pool 대신 CPU 를 늘려서 같은 효과를 얻을 수 있는지도 확인하였습니다. concurrency 1024 의 OFF 최대 지연은 vCPU 12 에서 1,121.69ms, vCPU 16 에서 1,075.70ms 입니다. 처리량은 같은 구간에서 39% 늘었는데도 최대 지연은 1초 수준에서 내려오지 않았습니다. 최대 지연이 중요한 경우라면 CPU 를 늘리는 것만으로는 효과를 보기 어려웠습니다.
즉, 이번 테스트에서 Thread Pool 은 처리량을 늘리지는 못했고, 동시 실행이 몰리는 구간에서 최대 지연이 낮게 나왔습니다. 동시 커넥션이 많을수록 Thread Pool ON 과 OFF 의 최대 지연 격차가 벌어졌고, CPU 가 적은 구간에서 그 격차가 더 컸습니다.
vCPU 4 의 concurrency 1024 에서는 OFF 가 4,261.27ms, ON 이 1,701.77ms 로 2,559.50ms 차이였고, vCPU 16 의 같은 구간에서는 1,075.70ms 와 496.70ms 로 579.00ms 차이였습니다.
thread_pool_size - 영향 없음
thread_pool_size 를 CoreCount 값으로 둔 경우와 vCPU 값으로 둔 경우를 비교하였습니다. CoreCount 는 vCPU 의 절반이므로 vCPU 4 구간이면 size 2 와 4, vCPU 16 구간이면 size 8 과 16 입니다. 아래 표는 concurrency 1024 구간의 QPS 입니다.
| 구간 | size = CoreCount | size = vCPU | 차이 |
|---|---|---|---|
| vCPU 4 | 25,556 | 25,508 | -0.19% |
| vCPU 8 | 51,412 | 51,388 | -0.05% |
| vCPU 12 | 79,181 | 79,034 | -0.19% |
| vCPU 16 | 110,932 | 109,811 | -1.01% |
4개 구간 모두 측정 편차 0.92% 안이거나 그에 가깝습니다. 그룹 수를 물리 코어 수로 두든 vCPU 수로 두든 처리량은 달라지지 않았습니다. concurrency 512 이하에서도 두 값의 차이는 최대 1.5% 입니다.
CPU 확장성 - 선형으로 증가
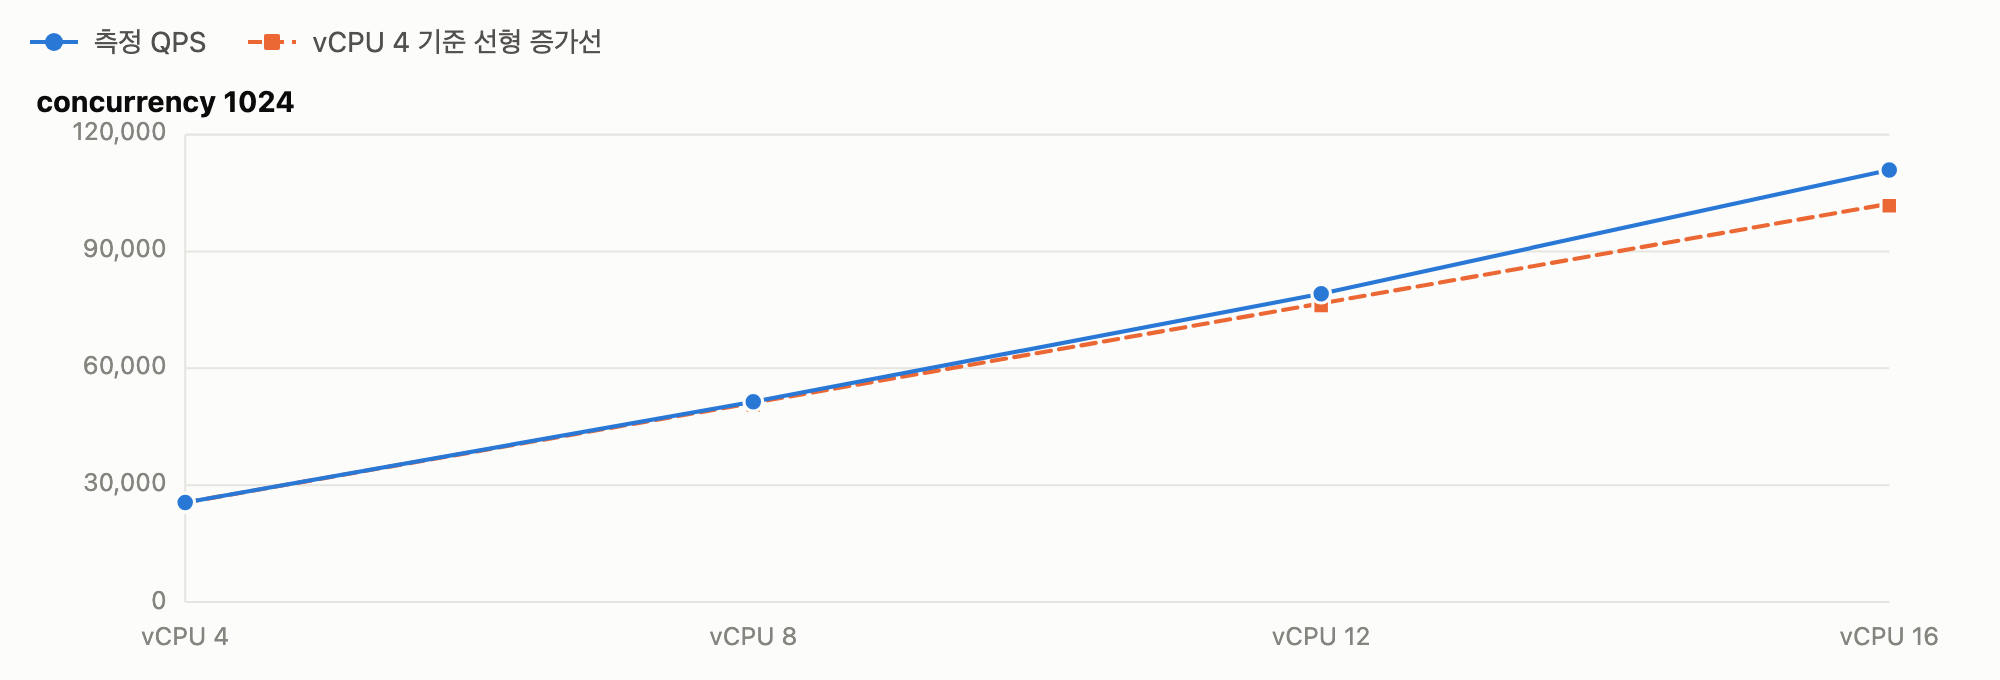
vCPU 를 늘린 만큼 처리량도 늘어나는지 확인하였습니다. concurrency 1024 에서 각 구간의 가장 높은 QPS 이며, 4개 구간 모두 Thread Pool ON 에 thread_pool_size 를 CoreCount 로 둔 회차입니다. 그래프의 점선은 vCPU 4 의 처리량을 CPU 수에 그대로 비례시킨 값입니다.
| 구간 | QPS | vCPU 4 대비 | CPU 배율 |
|---|---|---|---|
| vCPU 4 | 25,556 | 1.00× | 1× |
| vCPU 8 | 51,412 | 2.01× | 2× |
| vCPU 12 | 79,181 | 3.10× | 3× |
| vCPU 16 | 110,932 | 4.34× | 4× |
CPU 를 4배로 늘리자 처리량도 4.34배가 되었습니다. concurrency 128 구간에서도 2.05배, 3.14배, 4.28배로 거의 같은 비율이 나왔습니다. 동시성과 무관하게 CPU 수에 비례해 늘어났습니다.
여기에서 두 가지를 확인하였습니다.
첫째, 측정이 의도한 조건에서 이루어졌습니다. 데이터가 buffer pool 밖에 있어 디스크를 읽고 있었거나 락 경합이 있었다면 CPU 를 늘려도 이렇게 늘지 않았을 것입니다. 앞의 결과들은 CPU 수와 동시성 차이만 반영한 값입니다.
둘째, 이번 워크로드는 Thread Pool 이 효과를 보기 어려운 조건이었습니다. oltp_read_only 는 읽기만 하고 데이터도 전부 메모리에 올라가 있어 구문 하나하나가 빨리 끝납니다. Thread Pool 은 구문이 빨리 끝나지 않을 때 stall 로 판정하고 그룹에 listener 스레드를 더 투입하도록 합니다. 구문이 빨리 끝나면 그룹당 실행 스레드가 늘지 않습니다.
처리량은 CPU 를 증설한 만큼 증가하였고 Thread Pool 적용으로는 증가하지 않았습니다. 반대로 최대 지연은 vCPU 를 12 에서 16 으로 증설하여도 1,121.69ms 에서 1,075.70ms 로 거의 그대로였고, Thread Pool 적용 시에는 OFF 의 40 ~ 57% 수준으로 낮아졌습니다.
테스트 결과 요약
Thread Pool(스레드 풀)은 Enterprise Edition 에서만 제공되던 기능으로 성능 개선을 예상하였으나, 처리량과 최대 지연에서 결과가 다르게 나타났습니다.
차이가 작았던 지표
- 처리량 (QPS) — vCPU 4 / 8 / 12 / 16 의 4개 구간 모두 OFF 와의 차이가 2% 이내였고, concurrency 512 이하에서는 OFF 가 더 높았습니다.
- thread_pool_size 값에 따른 처리량 — 물리 코어 수로 설정한 경우와 vCPU 수로 설정한 경우의 처리량이 측정 편차 0.92% 안에서 같았습니다.
차이가 나타난 지표
- 최대 지연 (ms) — concurrency 1024 에서 Thread Pool ON 이 OFF 의 40 ~ 57% 수준이었습니다. 동시 커넥션이 많고 CPU 가 적은 구간일수록 격차가 컸습니다.
- CPU 증설로 내려가지 않던 구간 — vCPU 를 12 에서 16 으로 늘려 처리량 (QPS) 이 39% 증가하였으나 최대 지연은 1,121.69ms 에서 1,075.70ms 로 거의 그대로였습니다.
- 즉, 커넥션이 몰리고 CPU 가 부족한 환경일수록 최대 지연을 낮추는 효과가 크게 나타났습니다.
상황별로 정리하면 다음과 같습니다.
| 상황 | 이번 측정 결과 |
|---|---|
| 처리량 (QPS) 이 목표 | 달라지지 않았습니다. 4개 구간 모두 2% 이내이고, concurrency 512 이하에서는 OFF 가 높았습니다 |
| 응답 시간 상한이 중요 | 낮아졌습니다. concurrency 1024 의 최대 지연이 OFF 의 40 ~ 57% 수준입니다 |
| CPU 증설로 지연을 줄이려는 경우 | 최대 지연은 내려가지 않았습니다. vCPU 를 12 에서 16 으로 늘려 처리량 (QPS) 은 39% 증가하였으나, 최대 지연은 1,121.69ms 에서 1,075.70ms 로 4% 감소에 그쳤습니다 |
| vCPU 가 많고 동시 커넥션이 적음 | OFF 의 최대 지연이 더 낮았습니다. vCPU 12 의 concurrency 128, 256, 512 와 vCPU 16 의 concurrency 512 입니다. vCPU 가 많으면 커넥션당 스레드를 그대로 두어도 감당이 되었고, 같은 구간도 concurrency 1024 에서는 ON 이 더 낮았습니다 |
Conclusion
MySQL 26.7 버전에서 Thread Pool Plugin 이 Community Server 에 처음 포함되었습니다. 그동안 Enterprise Edition 에서만 사용 할 수 있던 기능이라 상용 라이선스 없이 동작을 확인할 수 있게 된 것이 이번 26.7버전의 변화입니다.
이번 글은 이 스레드 풀 기능을 확인 해보기 위해 EC2환경에 MySQL 26.7 버전을 설치하여 vCPU 4 / 8 / 12 / 16, concurrency 128 / 256 / 512 / 1024 조합으로 기능확인 및 성능 측정을 진행하였습니다.
Thread Pool 을 사용하면 성능(처리량)이 크게 개선될 수 있을 것이라고 예상이나 기대를 할 수 있습니다. 하지만 이번 측정에서 기대와 다르게 명확한 처리량 개선을 찾기는 다소 어려웠습니다. Thread Pool 은 동시에 실행되는 스레드 수를 CPU 가 감당할 수 있는 선으로 묶어 두는 쪽이고, 서버가 처리할 수 있는 일의 양 자체를 늘리는 쪽이 아니기 때문입니다.
대신 커넥션이 몰리는 구간의 최대 지연에서는 차이가 나타나서 개선된 것을 확인할 수 있었습니다.
Thread Pool(스레드 풀)은 사용하는 DB 서버의 사양(CPU 스펙), 그에 따른 Thread Pool Group 수 그리고 요청 스레드수 등에 따라서 개선점을 확인할 수도 있고, 반대로 사용하지 않을때 보다 오히려 처리량이 낮아지는 경우도 발생하는 것을 확인할 수 있었습니다.
그래서 스레드 풀을 사용하였을 경우 처리량이나 최대 지연 등 성능 개선점을 찾을 수도 있는 환경은 분명히 있을수 있지만, 반대로 스레드 풀 기능을 사용하기 적절한 환경(CPU, 처리 스레드수 등)을 찾는것도 어려운점이 될 수 있고 찾지 못할수도 있습니다.
또한 최적의 사용을 위해서 적절한 파라미터 수치값을 찾는것도 환경에 따라서 몇 번의 테스트와 검증으로 해당 시스템만의 최적의 값을 찾는 과정이 필요할 것이라고 생각하고 있습니다.
이처럼 스레드 풀을 사용하여 성능적인 개선이 될 수 있는 환경이나 조건을 찾는것은 여러 각도로 테스트 및 확인해보면서 조금은 조건 찾기가 까다롭거나 스레드 풀에 의해서 개선점을 확실히 느낄수 있는 환경을 찾기는 쉽지 않을 것 같다고 생각을 하게 되었습니다.
결론적으로 Thread Pool 적용이 의미가 있을 수 있는 환경인지, 파라미터는 어떤 값으로 설정 할 것인지, 이 기능이 필요할 만큼 부하가 높은 시스템인지 등을 먼저 고려나 확인이 필요할 것이라고 생각하며, 그에 따라서 적절한 사전 검증 및 테스트를 통해서 실제 운영 서비스에 점층적인 적용을 고려해야할 것 같다고 마지막으로 정리를 해볼 수 있을 것 같습니다.
이것으로 이 글을 마치겠습니다. 긴글 읽어주셔서 감사합니다.
Reference
- A More Predictable MySQL Release Model: Calendar Versions, LTS, and Innovation
- blogs.oracle.com/mysql/mysql-community-server-26-7-early-access-release
- dev.mysql.com/doc/refman/8.4/en/server-system-variables.html
- dev.mysql.com/doc/refman/9.7/en/server-system-variables.html
- dev.mysql.com/doc/refman/26.7/en/server-system-variables.html
- dev.mysql.com/doc/refman/26.7/en/thread-pool.html
- dev.mysql.com/doc/refman/26.7/en/thread-pool-operation.html
- dev.mysql.com/doc/refman/26.7/en/thread-pool-tuning.html
- blogs.oracle.com/mysql/the-new-mysql-thread-pool
Principal DBA(MySQL, AWS Aurora, Oracle)
핀테크 서비스인 핀다에서 데이터베이스를 운영하고 있어요(at finda.co.kr)
Previous - 당근마켓, 위메프, Oracle Korea ACS / Fedora Kor UserGroup 운영중
Database 외에도 NoSQL , Linux , Python, Cloud, Http/PHP CGI 등에도 관심이 있습니다
purityboy83@gmail.com / admin@hoing.io


